> ## Documentation Index
> Fetch the complete documentation index at: https://dragonwingdocs.qualcomm.com/llms.txt
> Use this file to discover all available pages before exploring further.
# LiteRT 概述
> 在 Qualcomm Dragonwing IoT 平台上用于端侧 AI 推理的 LiteRT 框架概述,包括支持的委托(delegate)和加速器。
\*\*LiteRT(Lite Runtime)\*\*是一个为高效端侧深度学习推理而设计的开源框架。它提供工具,可将预训练模型(如 TensorFlow SavedModel 或 Keras)转换为 LiteRT 格式,并针对边缘部署进行优化。
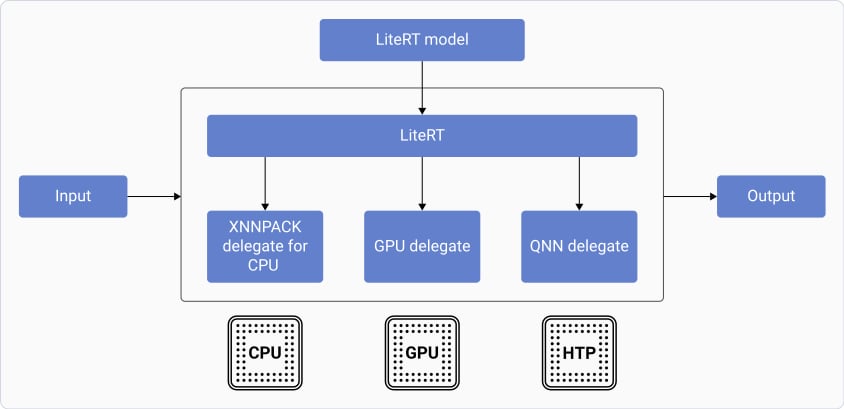
在 Qualcomm Linux 平台上,LiteRT 模型既可以通过原生 LiteRT 应用执行,也可以通过基于 GStreamer 的 Qualcomm 智能多媒体 SDK 执行。该框架通过委托(delegate)支持多种硬件加速器,包括 CPU、GPU 和 Qualcomm Hexagon™ 张量处理器。它针对移动、嵌入式和边缘设备上的低延迟、紧凑模型体积和高能效性能进行了优化。
下图展示了 LiteRT 框架用于运行模型的各种委托:
 ## LiteRT 端侧推理
LiteRT 端侧推理过程将模型加载到解释器中,解释器解析模型并使用委托来运行它。
该过程包括以下步骤:
1. 推理将 LiteRT 模型加载到 LiteRT 解释器接口中,解释器解析模型以识别其中包含的神经网络算子。
2. 配置解释器接口以使用委托运行模型。
3. 解释器对提供的输入调用模型推理,并将相应的输出保存到提供给解释器接口的缓冲区中。
Qualcomm 支持通过委托在以下加速器上运行 LiteRT 模型:
* CPU
* Adreno GPU
* NPU
**支持的委托和加速器**
| 委托 | 加速 |
| ------------------------------------- | ------------- |
| XNNPACK 委托 | CPU |
| GPU 委托 | GPU |
| Qualcomm® AI Engine Direct 委托(QNN 委托) | CPU、GPU 和 NPU |
## 后续步骤
有关每种委托的详细信息及其使用方法,请参见[支持的 LiteRT 运行时](../topic/run-a-litert-model)。