> ## Documentation Index
> Fetch the complete documentation index at: https://dragonwingdocs.qualcomm.com/llms.txt
> Use this file to discover all available pages before exploring further.
# 使用 Qualcomm 生成式 AI(GenAI)推理扩展(Genie)运行 GenAI 模型
> 使用 Genie 框架和 CLI 工具在 Qualcomm Dragonwing IoT 平台上运行大语言模型(LLM)和多模态模型。
Genie 是一个高级框架,用于在 Qualcomm 平台上运行 GenAI 模型,例如 LLM、视觉 Transformer
和多模态模型。它抽象了管理多个二进制文件的复杂性,并在异构计算单元
(CPU、GPU、NPU)之间编排执行,提供低延迟、高能效和用户易用性。
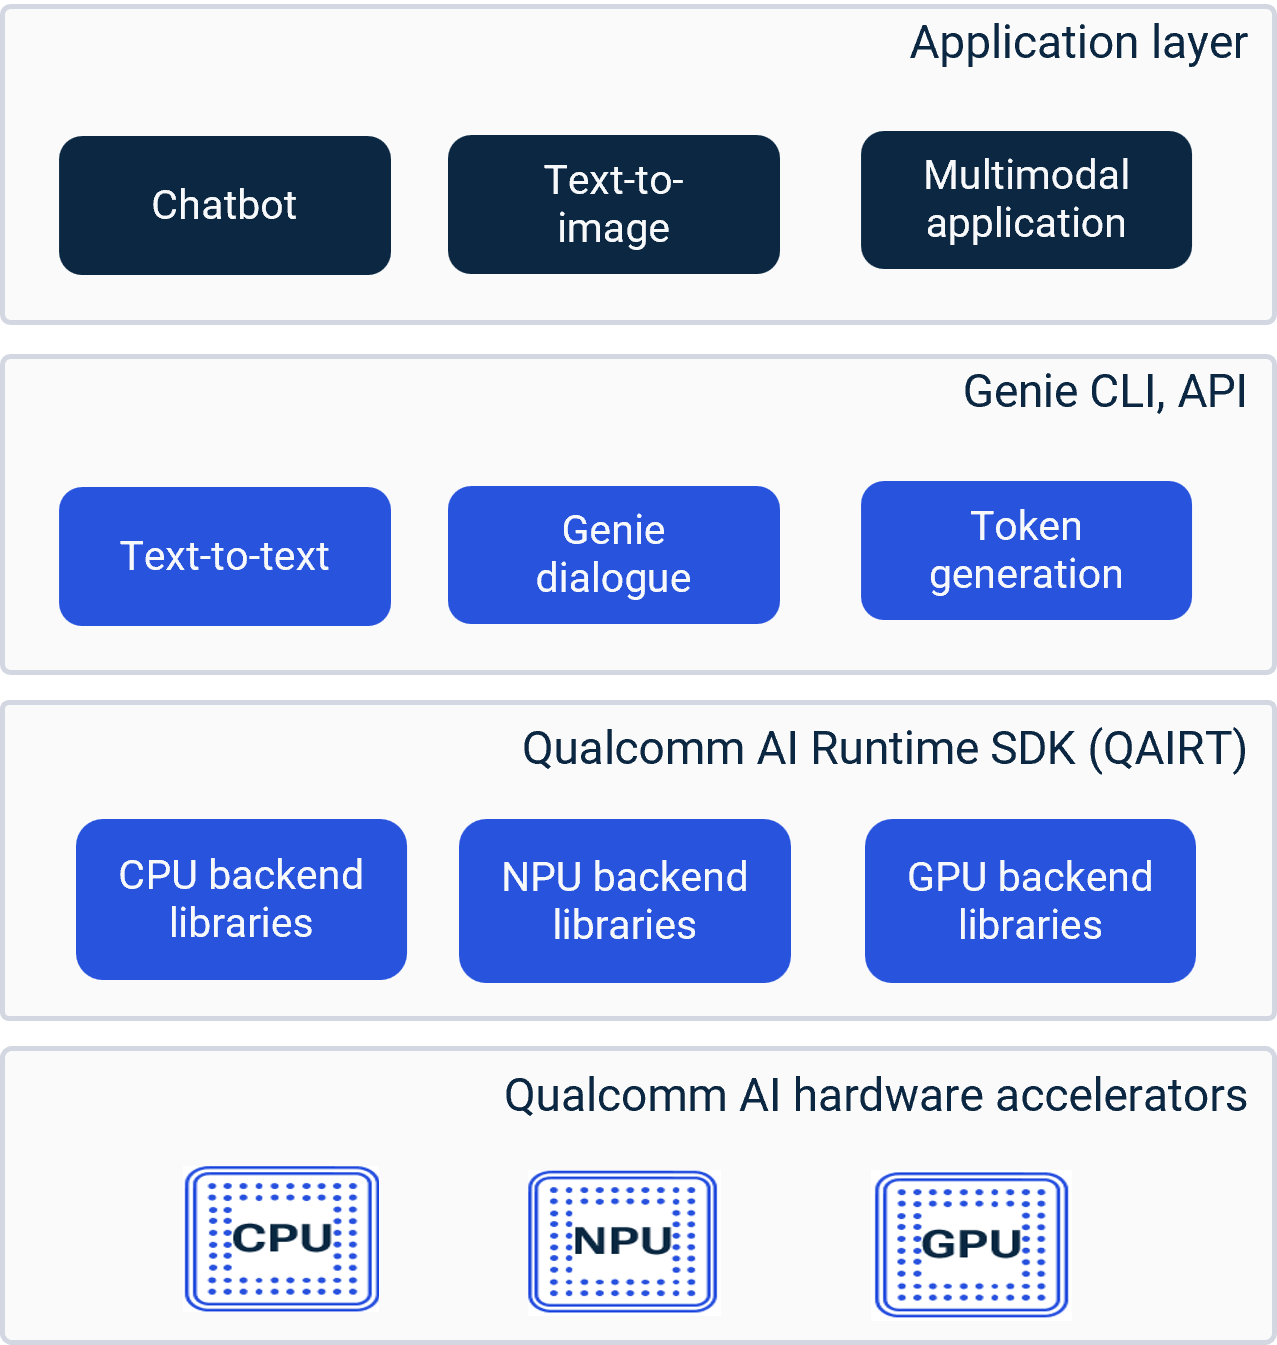 以下 JSON 配置、Genie 工具和 C API 是在设备上准备、执行和管理
GenAI 模型的基本组件。
| 组件 | 用途 | | | | | | |
| --------- | ---------------------------------- | ------------------------ | ---------------------------------------------------------------------------------------------------------- | ----------------- | ----------------------- | ------------------------------------ | --------------------------------------------------------------------------------------------------------------------------- |
| JSON 配置 | 主要功能: | 指定后端选择(CPU 或 NPU)。 | 配置模型路径、分词器设置和内存分配。 | 管理多轮对话的会话参数。示例字段: | `backend`:"CPU" 或 "NPU" | `model_bundle_path`:Genie 模型二进制文件的路径 | `max_tokens`:token 生成上限。更多详情请参阅 [Qualcomm AI Engine Direct](https://docs.qualcomm.com/doc/80-63442-10/topic/index_QNN.html) |
| Genie 工具 | 用于模型执行和性能分析的命令行类工具。常用工具: | `genie-t2t-run`:文本到文本推理。 | `genie-profile`:性能分析。更多详情请参阅 [Qualcomm AI Runtime (QAIRT) SDK](https://docs.qualcomm.com/doc/80-63442-10)。 | | | | |
| Genie API | 提供编程访问,以便将 Genie 集成到 GenAI 应用中。功能: | Dialogue API:支持多轮对话工作流。 | Token 生成 API:处理 LLM 的增量 token 流式输出。优势: | 支持自定义应用逻辑。 | 提供对推理会话的细粒度控制。集成: | 与 QAIRT SDK 配合进行后端执行。 | 支持 CPU 和 NPU 目标。更多详情请参阅 [QAIRT](https://docs.qualcomm.com/doc/80-63442-10) |
## 使用 Genie 运行 LLM
在您的大语言模型(LLM)准备和优化完成后
(使用 [AI Hub](../topic/genai-prepare-ai-hub) 或
[Jupyter notebooks](../topic/genai-prepare-jupyter)),
Genie 提供了一种简化的方式在 Qualcomm 平台上执行它。
### 前提条件
在使用 Genie 运行语言模型之前,请确认满足以下前提条件。
* 模型包已针对正确的后端(CPU 或 NPU)导出并准备完成,且包含
AI Engine Direct(QNN)二进制文件、分词器文件和配置文件。
* 目标设备上已安装 QAIRT,且 Genie 工具和库作为
SDK 的一部分可用。
* 目标硬件使用具有充足内存的 Qualcomm 平台(RAM 和存储,用于复制和执行模型二进制文件)。
下图显示了使用 Genie 通过 `genie-t2t-run` 运行 LLM 所需的输入。
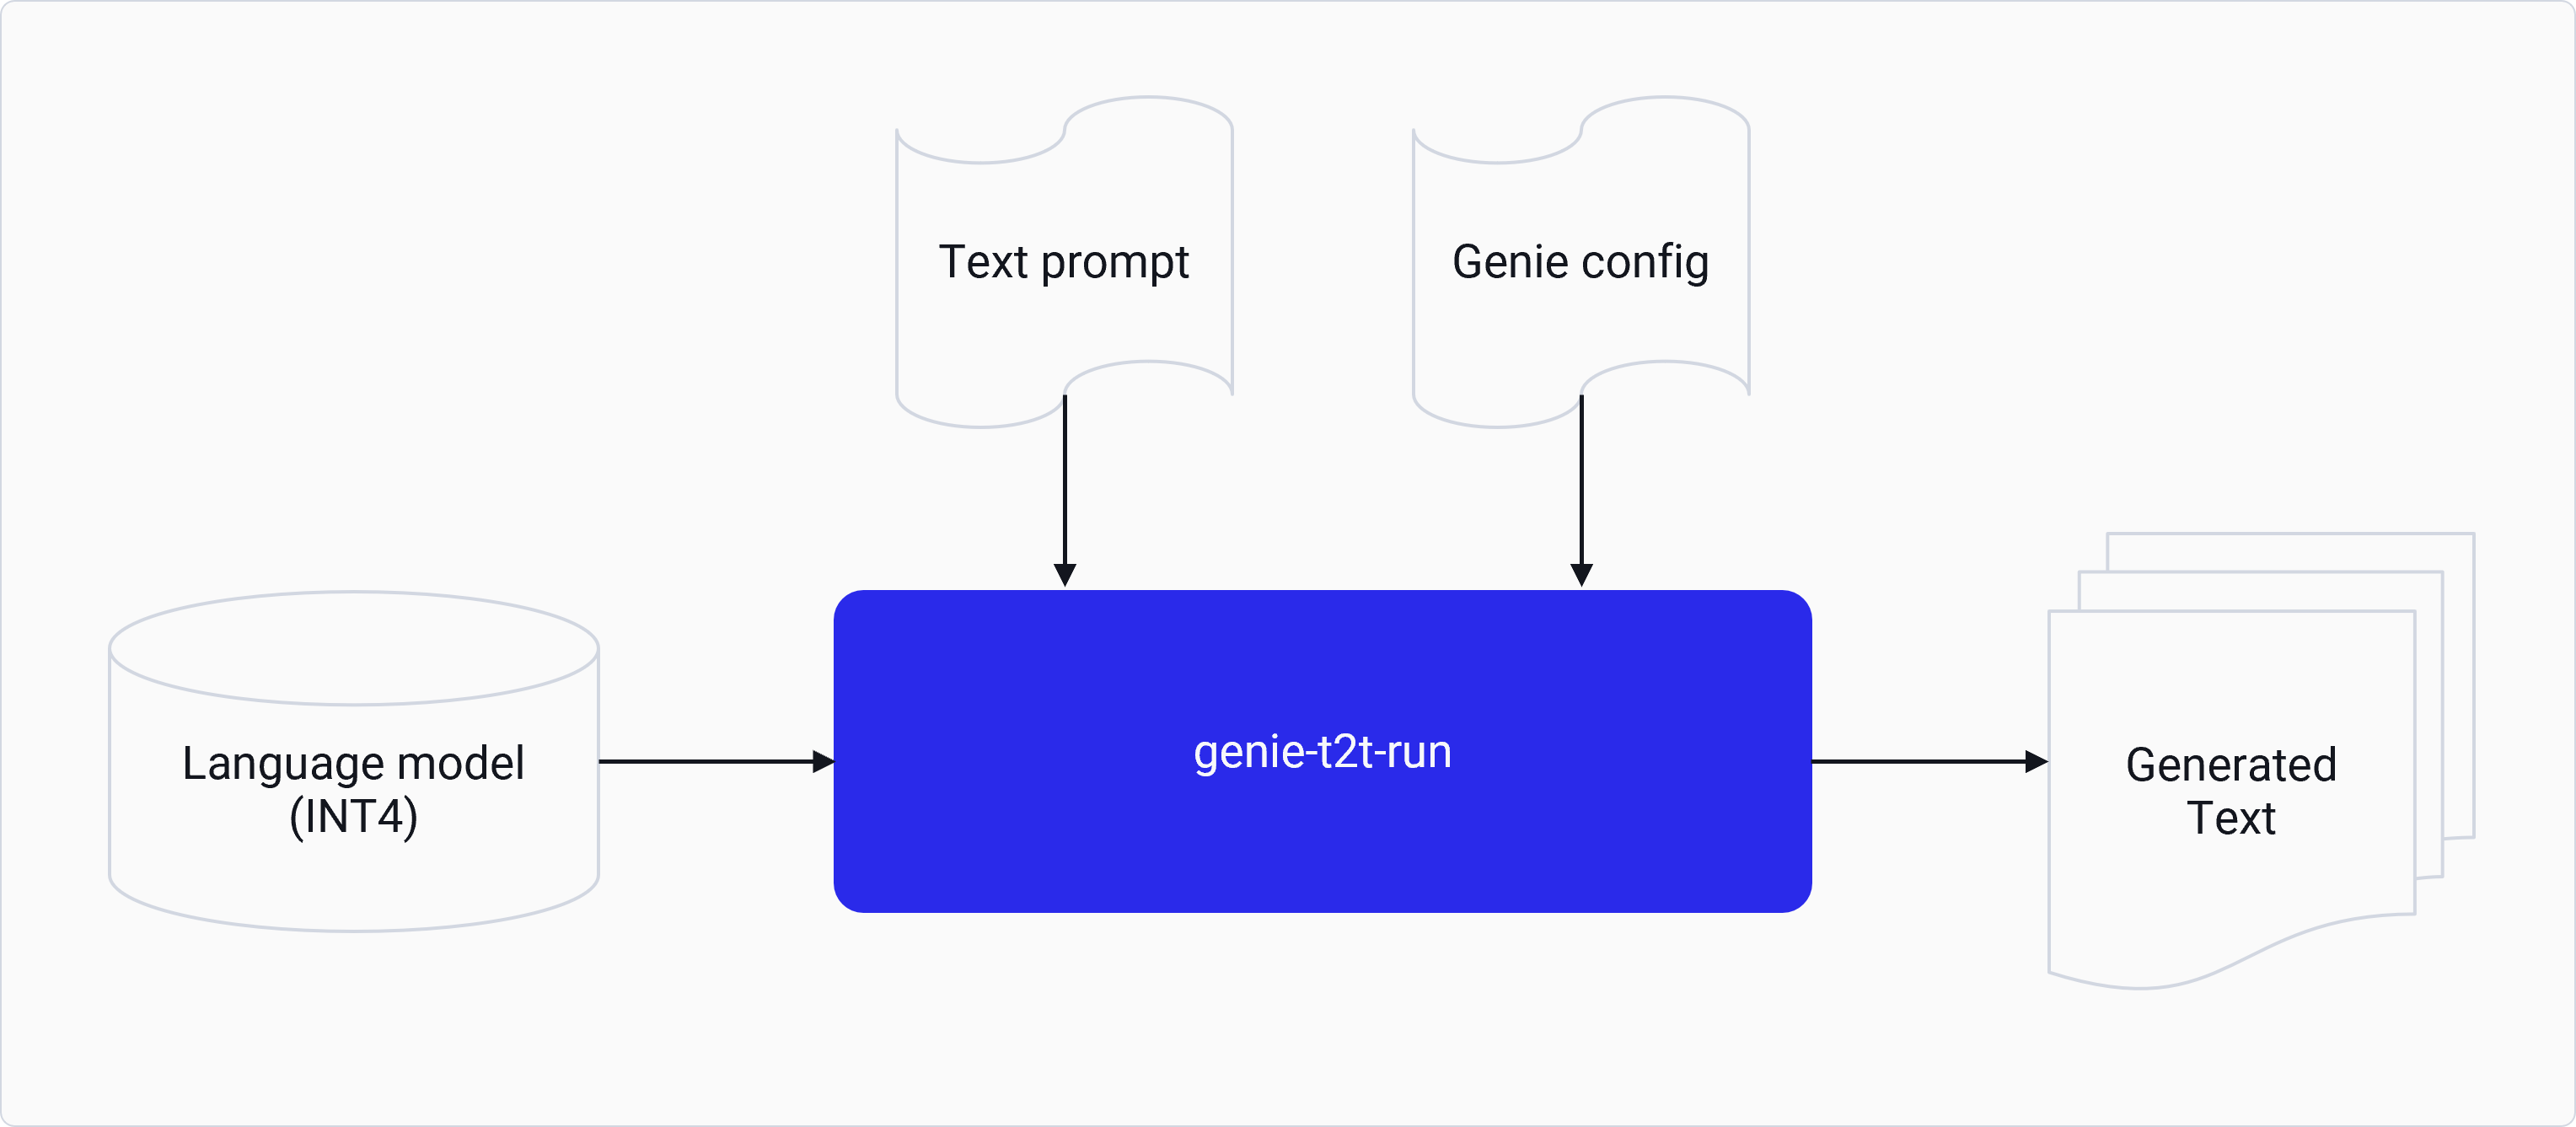 `genie-t2t-run` 工具是一个测试应用,用于对提供的 LLM 网络执行文本到文本推理。
它接收文本格式的用户提示词,并以文本格式输出结果。它提供了一个开箱即用的
命令行界面(CLI),可在受支持的 Qualcomm 设备上使用 CPU、GPU 和 Hexagon Tensor Processor(HTP)后端运行 LLM 推理。
Genie 使用预优化的模型资产,将多二进制文件的 LLM 执行简化为单一任务。
以下代码片段显示了一个示例 `genie-t2t-run` 命令。
```
genie-t2t-run -c genie_config.json -p "Tell me about Qualcomm"
```
下图显示了 `genie-t2t-run` 命令的调用流程。
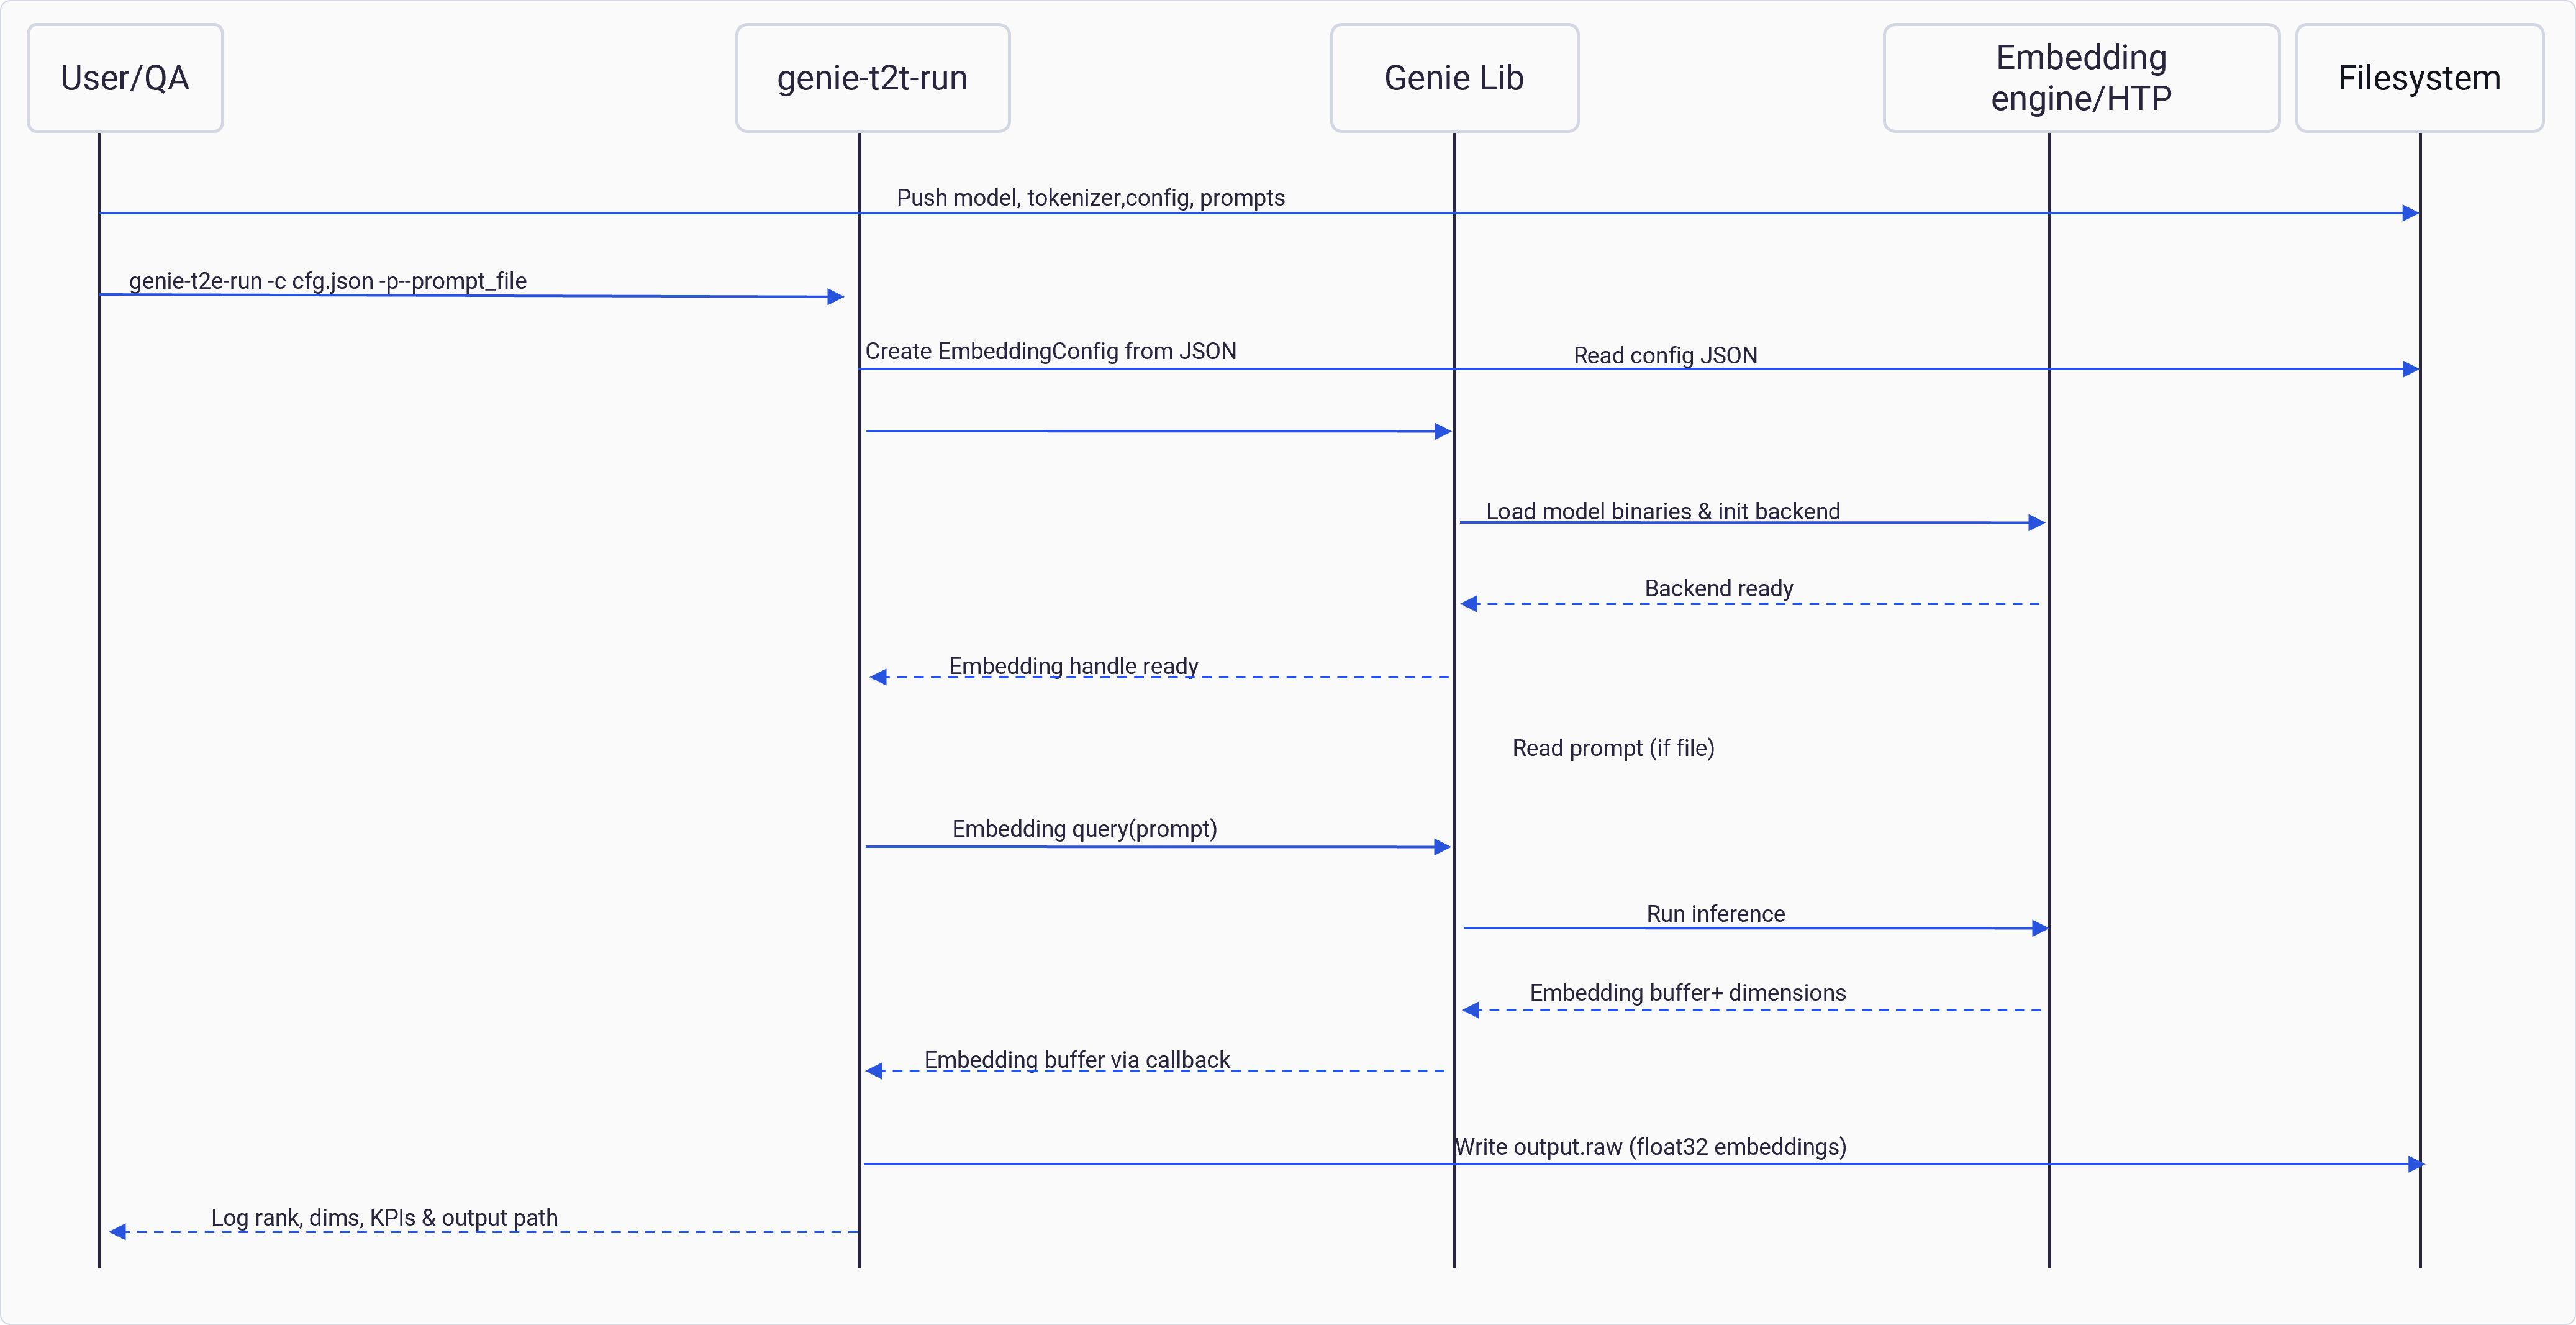 以下步骤详细说明如何将 LLM 制品推送到目标设备并使用 Genie 运行
LLM 模型。在运行 `genie-t2t-run` 之前,您需要将模型准备步骤生成的
genie-bundle 复制到目标设备。
1. 从主机使用目标设备的 IP 地址连接到目标设备。
```shell theme={null}
ssh root@
```
2. 在目标设备上,在上一步的 SSH 会话中,创建一个用于保存模型制品的目录:
```shell theme={null}
mkdir -p /tmp
```
3. 从主机将运行模型所需的库和二进制文件推送到目标设备。
```shell theme={null}
scp ${QNN_SDK_ROOT}/bin/aarch64-oe-linux-gcc11.2/genie-t2t-run root@:/tmp/
```
```shell theme={null}
scp ${QNN_SDK_ROOT}/lib/aarch64-oe-linux-gcc11.2/libGenie.so root@:/tmp/
```
```shell theme={null}
scp ${QNN_SDK_ROOT}/lib/aarch64-oe-linux-gcc11.2/libQnnHtp.so root@:/tmp/
```
```shell theme={null}
scp ${QNN_SDK_ROOT}/lib/aarch64-oe-linux-gcc11.2/libQnnSystem.so root@:/tmp/
```
```shell theme={null}
scp ${QNN_SDK_ROOT}/lib/aarch64-oe-linux-gcc11.2/libQnnHtpPrepare.so root@:/tmp/
```
```shell theme={null}
scp ${QNN_SDK_ROOT}/lib/aarch64-oe-linux-gcc11.2/libQnnHtpNetRunExtensions.so root@:/tmp/
```
在以下命令中,将 `` 替换为 DSP Hexagon 架构库版本。
| 设备 | 架构 |
| ------------------------------ | ---- |
| IQ-8275 | `75` |
| IQ-9075/QCS9100 | `73` |
| Qualcomm Dragonwing™ RB3 Gen 2 | `68` |
```shell theme={null}
scp ${QNN_SDK_ROOT}/lib/aarch64-oe-linux-gcc11.2/libQnnHtpVStub.so root@:/tmp/
```
```shell theme={null}
scp ${QNN_SDK_ROOT}/lib/hexagon-v/unsigned/libQnnHtpVSkel.so root@:/tmp/
```
4. 从主机将模型二进制文件和配置文件推送到目标设备。
```shell theme={null}
scp root@:/tmp/
```
```shell theme={null}
scp root@:/tmp/
```
```shell theme={null}
scp root@:/tmp/
```
```shell theme={null}
scp root@:/tmp/
```
5. 在目标设备上运行模型。
```shell theme={null}
export LD_LIBRARY_PATH=/tmp/
```
```shell theme={null}
export PATH=$LD_LIBRARY_PATH:$PATH
```
```shell theme={null}
cd $LD_LIBRARY_PATH
```
```shell theme={null}
./genie-t2t-run -c -p "What's the most popular cookie in the world?"
```
使用来自
[JSON 配置文件](https://docs.qualcomm.com/doc/80-63442-10/topic/json.html#genie-dialog-json-config-string)的
`backend::type` 参数选择运行时
| 参数 | 后端 | 描述 |
| --------------- | ---- | ------------------------------------------------------------------------------------------ |
| `backend::type` | 所有后端 | 要使用的引擎:QNN HTP 后端:`QnnHtp`,QNN AI transformer 后端:`QnnGenAiTransformer`,QNN GPU 后端:`QnnGpu` |
可通过 [AI Hub](https://github.com/qualcomm/ai-hub-apps/tree/main/tutorials/llm_on_genie/configs/genie)
获取不同模型的示例 Genie 配置。
## 使用 Genie 运行多模态模型
要使用 Genie 运行多模态模型,请使用 GenAI 教程(可在 Qualcomm Package Manager 中获取)
生成模型,并使用 Genie 工具运行它们。
AI Hub 中未托管任何多模态模型。
用户必须使用 Jupyter notebooks 来生成和运行模型。
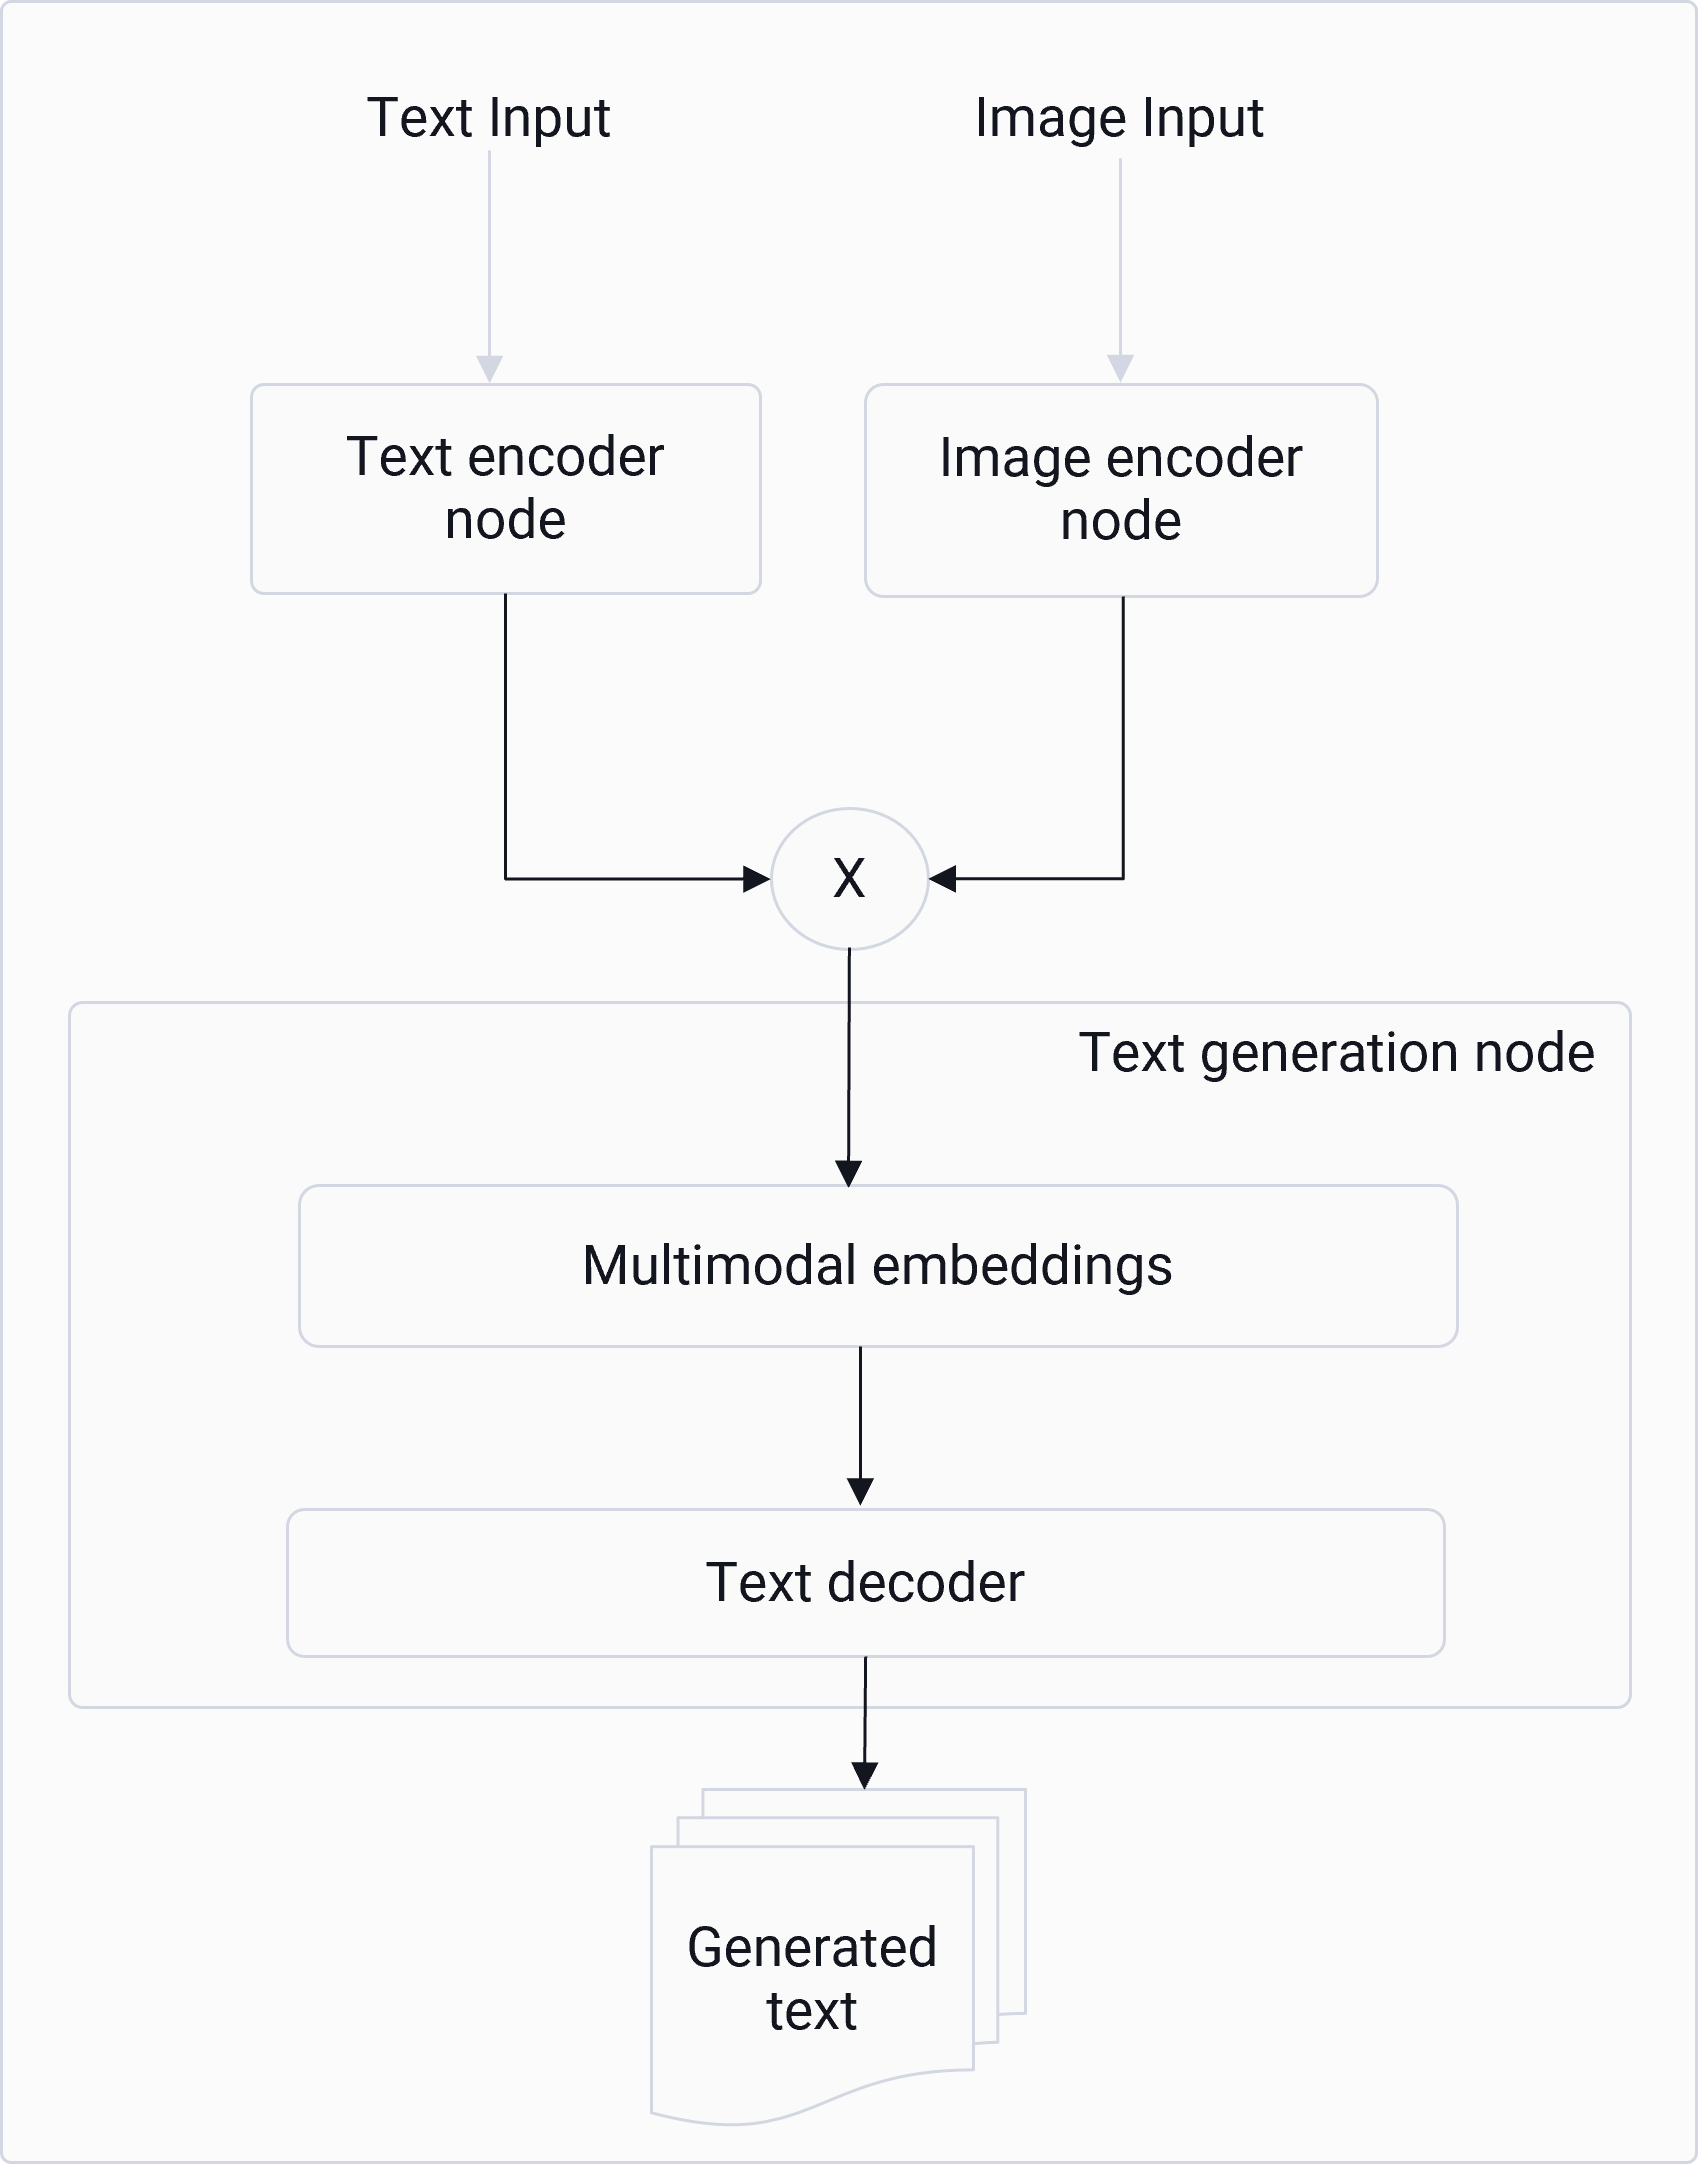
使用 Genie 执行多模态模型是通过 Genie 管线完成的。
* Genie Node API:用于创建各个模块。每个节点的创建都需要一个独立的 JSON
配置,类似于对话(dialog)配置。
* `text-encoder`
* `image-encoder`
* `text-generator`
* Genie Pipeline API:用于连接节点并简化执行。Genie 管线管理
内部数据类型转换、重新量化和拼接操作。
 ### Genie 管线阶段
1. 创建节点。
a. 创建节点配置。节点 JSON 配置因节点类型而异。
更多信息,请参阅 [node JSON](https://docs.qualcomm.com/doc/80-63442-10/topic/node_json.html)
```
Genie_Status_t GenieNodeConfig_createFromJson(const char* str,
GenieNodeConfig_Handle_t* configHandle);
```
1. 创建节点。
```
Genie_Status_t GenieNode_create(const GenieNodeConfig_Handle_t nodeConfigHandle,
GenieNode_Handle_t* nodeHandle);
```
1. 构建管线。
a. 从节点配置创建管线。
```
Genie_Status_t GeniePipelineConfig_createFromJson(const char* str,
GeniePipelineConfig_Handle_t* configHandle);
```
1. 将节点添加到管线中。
```
Genie_Status_t GeniePipeline_create(const GeniePipelineConfig_Handle_t configHandle,
GeniePipeline_Handle_t* pipelineHandle);
```
1. 连接节点。
* 每种节点类型都有一组预定义的 IO 名称。这些定义在 `GenieNode.h` 中。
例如,文本生成器节点具有两个可能输入之一和一个输出:
* 输入:`GENIE_NODE_TEXT_GENERATOR_TEXT_INPUT`
* 输入:`GENIE_NODE_TEXT_GENERATOR_EMBEDDING_INPUT`
* 输出:`GENIE_NODE_TEXT_GENERATOR_TEXT_OUTPUT`
* Genie 管线的 connect API 定义了从一个生产者节点输出到一个
消费者节点输入的连接。例如:
```
GeniePipeline_connect(pipelineHandle,
lutEncoder,
GENIE_NODE_TEXT_ENCODER_EMBEDDING_OUTPUT,
textGenerator,
GENIE_NODE_TEXT_GENERATOR_EMBEDDING_INPUT)
```
1. 运行管线。
a. 为输入节点设置数据。
```
Genie_Status_t GenieNode_setData(const GenieNode_Handle_t nodeHandle,
const GenieNode_IOName_t nodeIOName,
const void* data,
const size_t dataSize,
const char* dataConfig);
```
* 使用预定义的 IO 名称(与 connect API 中相同)
* IO 名称隐式定义了数据类型
1. 运行管线。
```
Genie_Status_t GeniePipeline_execute(const GeniePipeline_Handle_t pipelineHandle,
void* userData);
```
* 注册到输出节点的回调将返回输出。
## Genie API
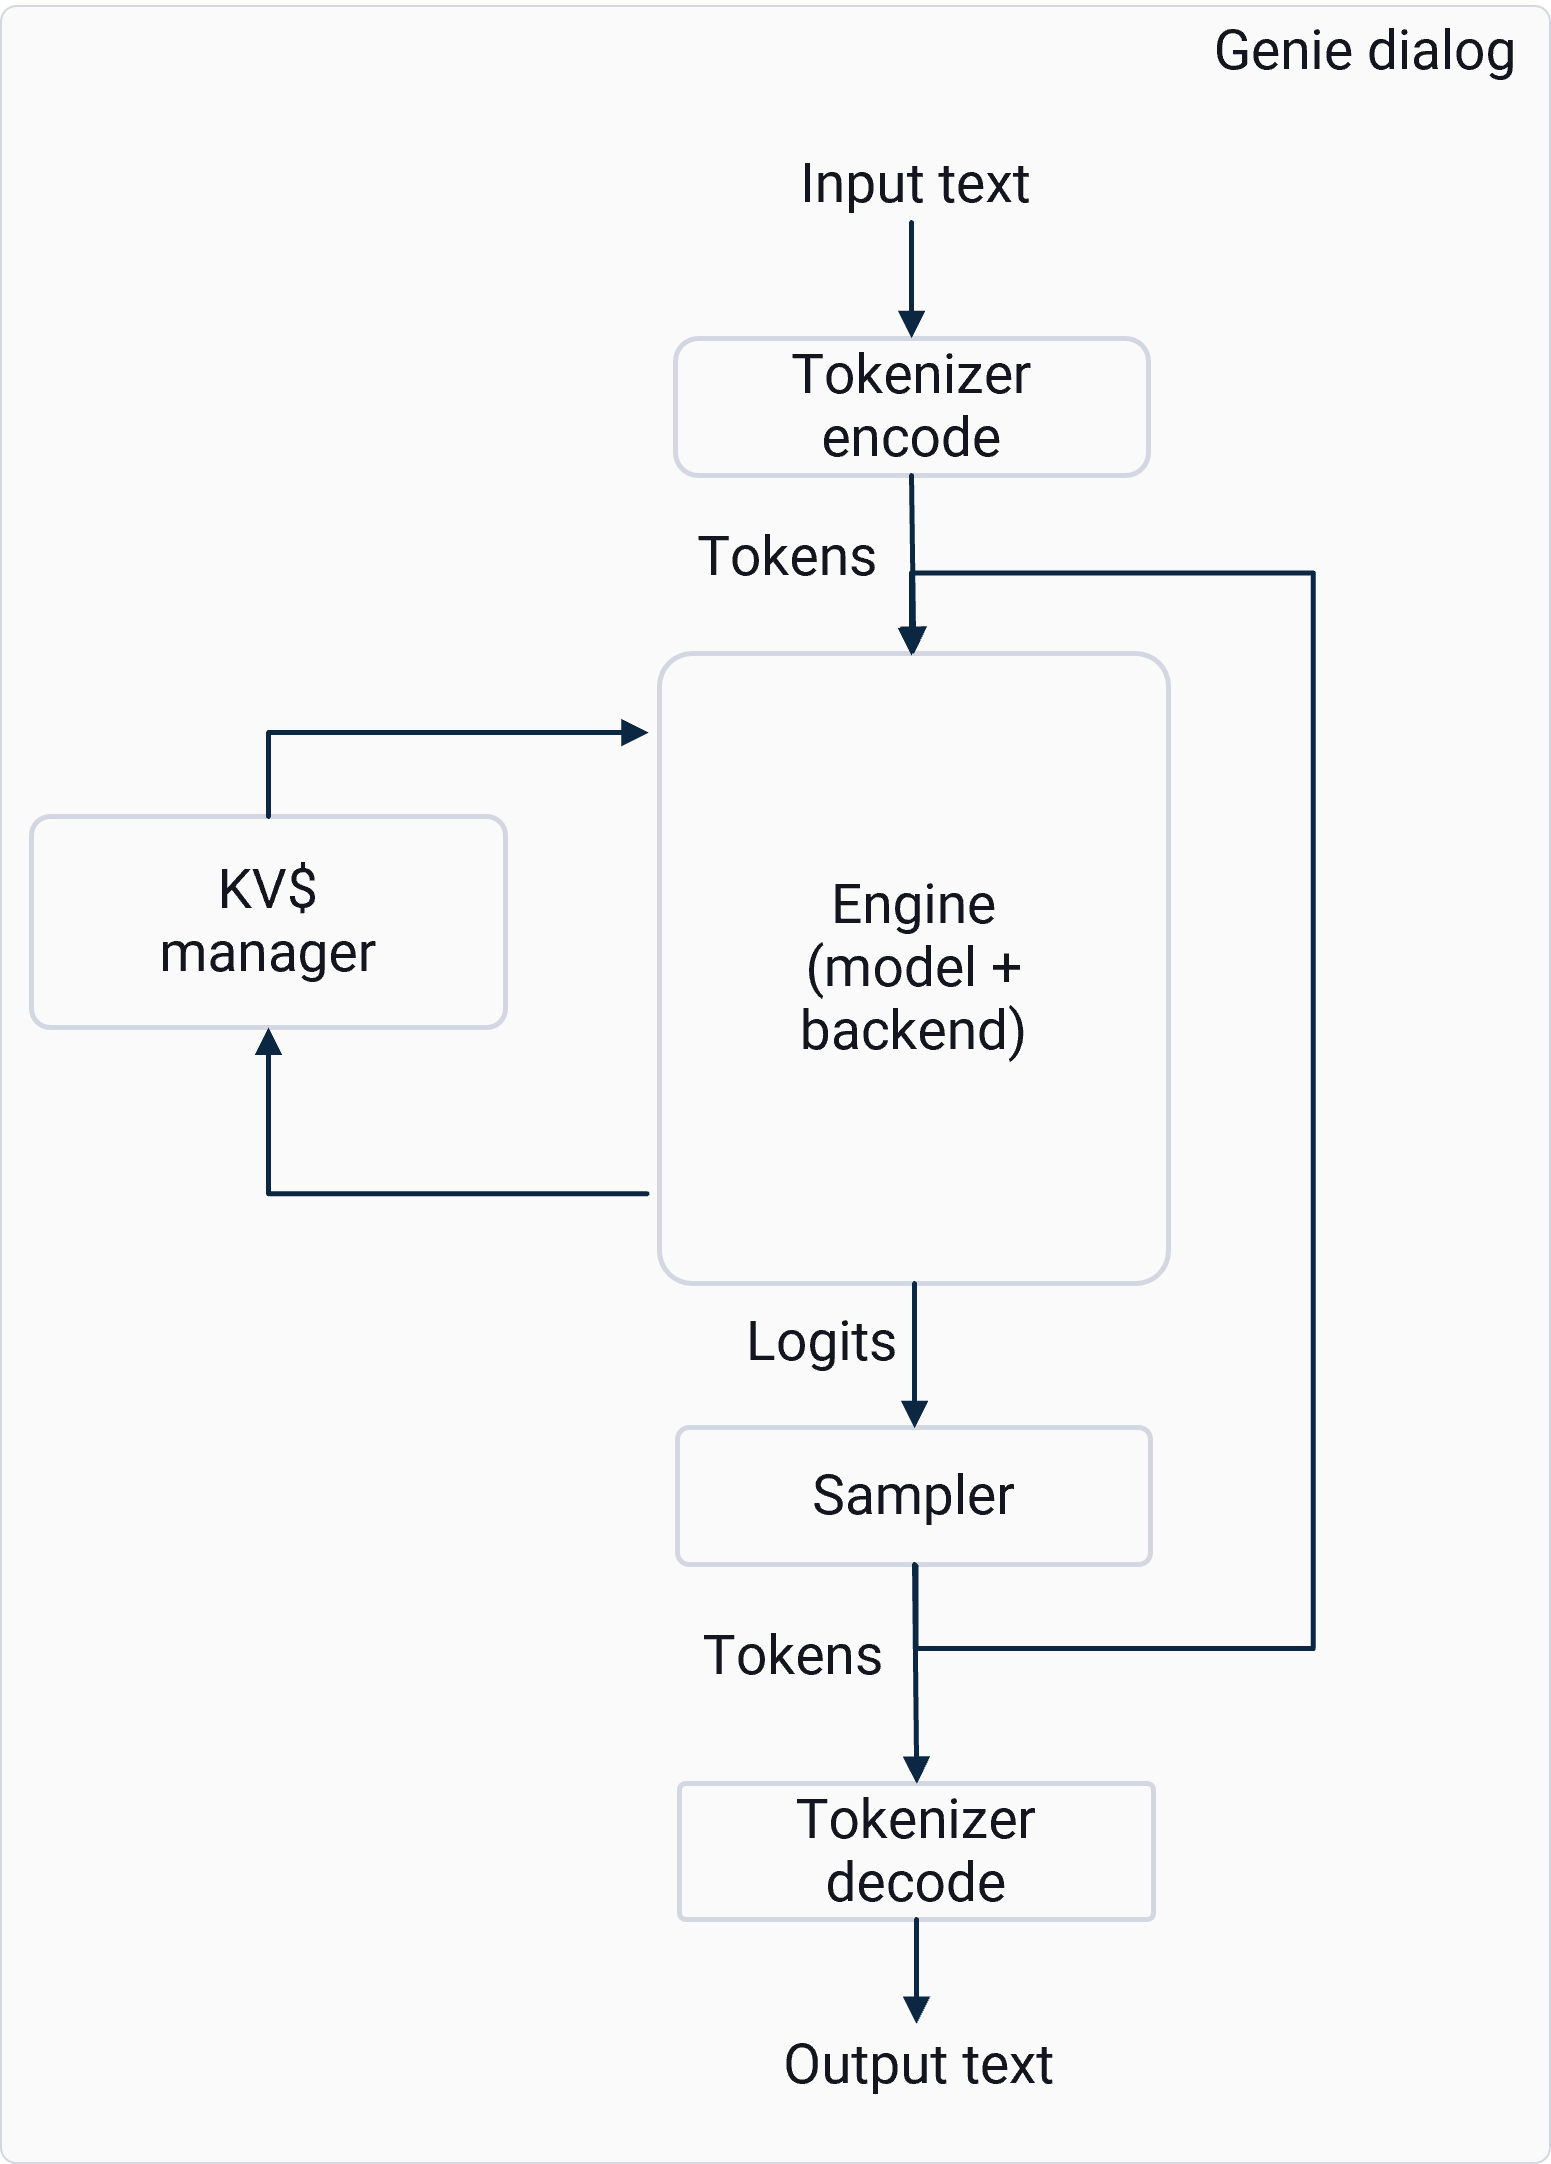
Genie API 是在 Qualcomm 设备上运行 LLM 管线的高级接口。
它将分词器、引擎(QNN 后端)、KV-cache 管理、解码和采样
封装到对话和 token 生成流程中,同时将设备执行委托给使用
HTP/NPU 和 CPU 后端的 QAIRT。
下图显示了 Genie API 内部处理的高级功能。
您可以使用 Genie C API 根据您的 LLM 应用需求配置每个组件。
 Genie API 包含以下组件。
如需完整的函数定义和头文件级别的详细信息,请参阅 [Genie API 文档](https://docs.qualcomm.com/doc/80-63442-10/topic/library.html)
* `GeniePipeline`:通过将分词器、引擎、采样器
和其他节点链接成可运行的管线来编排整个推理工作流。它管理文本生成
或嵌入任务的数据流和执行顺序。
* `GenieNode`:表示管线中的单个处理单元(分词器、引擎)。
节点封装了特定功能,可用于构建自定义推理图。
* `GenieDialog`:面向对话任务的高级抽象。它使用 JSON 配置将分词器、
模型、后端和采样器连接在一起,并提供用于 token 生成和嵌入的 API。
* `GenieEmbedding`:处理用于检索增强生成(RAG)或语义搜索的嵌入查询。
使用已加载的模型将输入文本转换为稠密向量表示。
* `GenieProfile`:存储配置和运行时参数,例如后端选择、采样策略
和性能设置。配置文件(profile)允许在不同的推理设置之间快速切换。
* `GenieSampler`:实现解码策略(例如贪婪解码、top-k 或 top-p 采样),将
模型 logits 转换为输出 token。支持高级加速技术,如推测解码(SPD)、
自推测解码(SSD)和前瞻解码(LADE)。
* `GenieEngine`:在所选后端(HTP、GenAI transformer 或 CPU)上执行模型前向传播。
它管理图执行、内存分配和硬件加速。
* `GenieTokenizer`:在推理过程中将文本转换为 token ID 并转换回文本。与特定于模型的
词表配合工作,并支持多轮对话的高效编码/解码。
下图显示了端到端 LLM 聊天机器人应用中 Genie API 的示例调用流程。