

AI / ML
代码仓库: github.com/eivholt/qai-nemotron
目标设备: Qualcomm Dragonwing IQ-9075 EVK / QCS9075 / Hexagon v73。硬件由 Qualcomm 慷慨赞助。
模型: nvidia/Llama-3.1-Nemotron-Nano-8B-v1
运行时结果: 在 EVK 上首个 token 时间 183 ms,生成速度 10.03 tokens/s 部署在边缘侧的语言模型正处于成为传统控制流编程有用替代方案的临界点。虽然令人兴奋,但本地模型的选择可能很棘手,这与大型前沿模型形成鲜明对比。较大的模型是更宽容的多面手,而可部署到边缘的小模型则需要精心挑选。官方模型基准测试和排行榜可以让你大致了解某个模型擅长什么,但它们往往掩盖了实际使用中的怪癖或局限。评估一个模型唯一可靠的方法,就是把它跑在终端设备上并运行一些有代表性的测试。
本教程实现的内容
在本教程中,我将分享我的完整历程:拿到 NVIDIA 的 BF16Llama-3.1-Nemotron-Nano-8B-v1 检查点,将其量化为 Qualcomm 的 W4A16 部署格式,在 Qualcomm AI Hub Workbench 中为 QCS9075 编译,在物理 IQ-9075 EVK 上安装匹配的 QAIRT 运行时,并通过 Genie 在 Hexagon HTP/NPU 上运行该模型。
我的朋友创造了一个说法:“就像爵士音乐会上的掌声”。正如不听爵士乐的人可能会对 23 分钟爵士即兴演奏中间突然爆发的欢呼感到困惑一样,这项技术练习的成就可能并不显而易见,也很容易被误解。
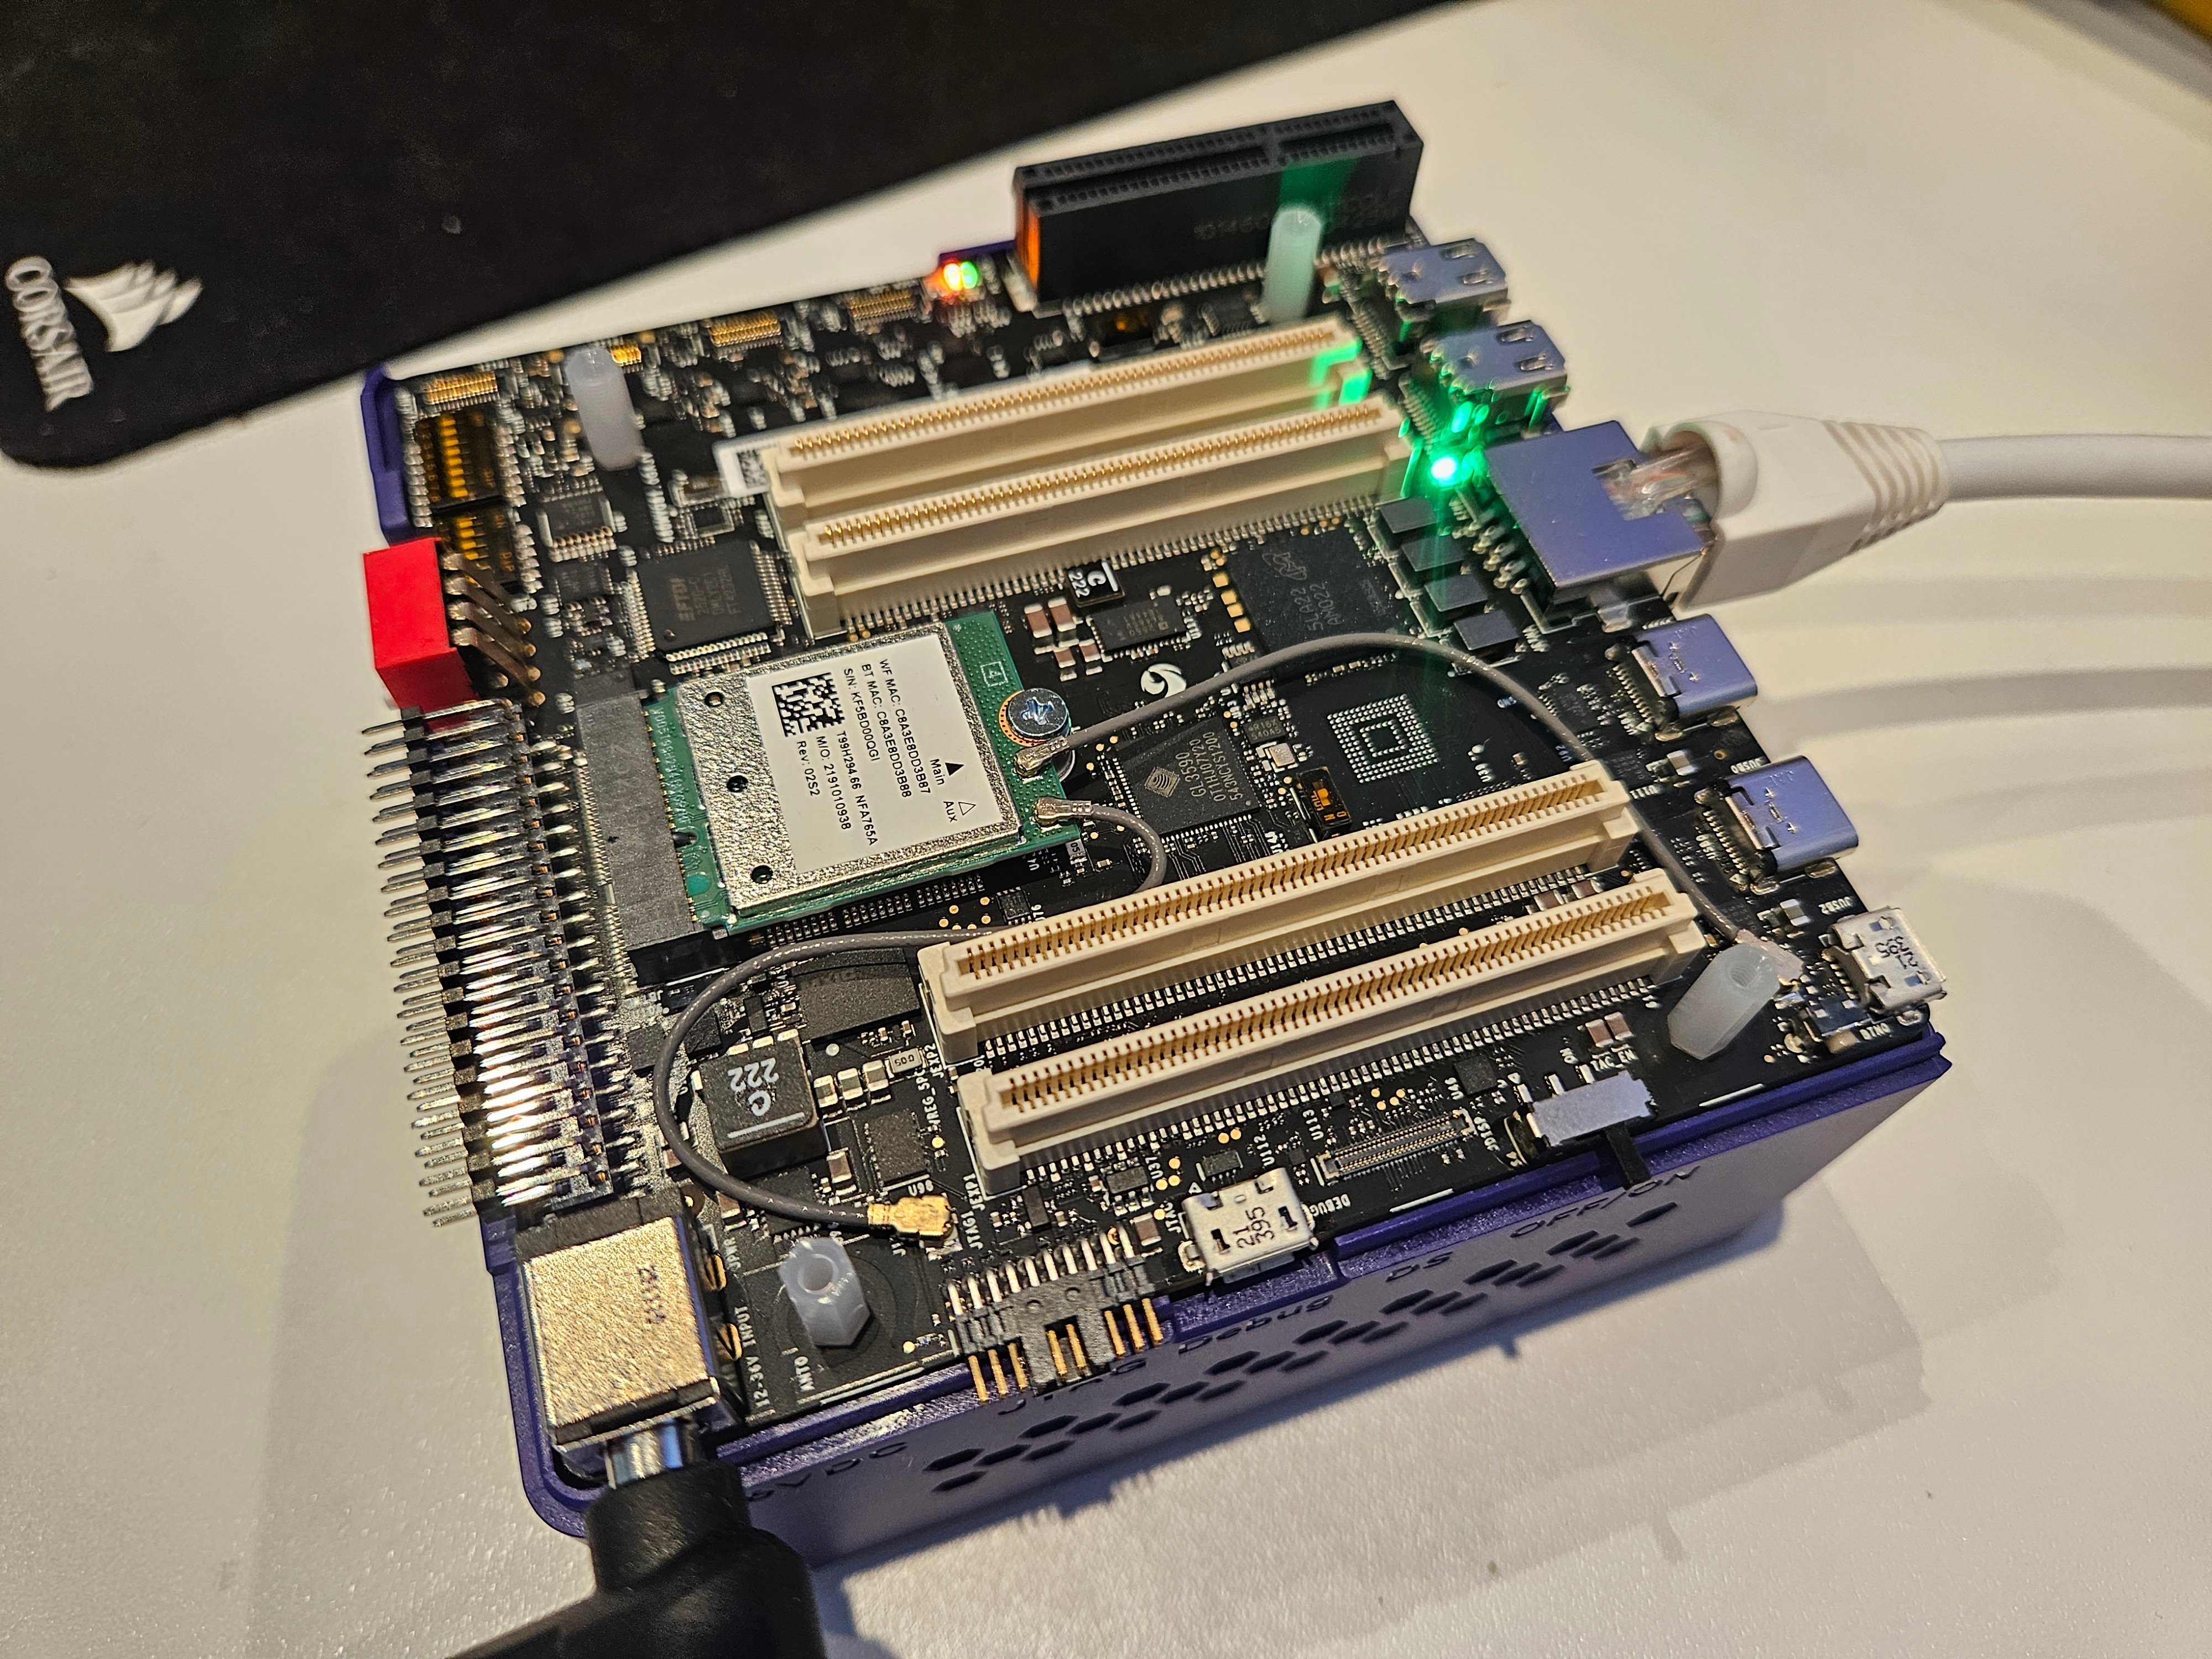
QnnHtp 后端和物理 EVK 的 Hexagon v73 DSP。在经过验证的运行中,模型以 10.03 tokens/s 的速度生成连贯输出,基本与 Qualcomm 公布的原版 Llama 3.1 8B 在同一平台上的性能持平。
一个重要的架构澄清
这个特定的 Nemotron 模型不是新的 Mamba 或混合专家(mixture-of-experts)网络。NVIDIA 将其定义为一个稠密的仅解码器 Transformer,网络架构与 Llama 3.1 8B Instruct 相同。它的差异化在于 NVIDIA 的后训练:推理开/关行为、工具调用、RAG、编码、指令遵循、偏好优化和强化学习。 正是这种架构兼容性,使得 Qualcomm 现有的 Llama 3.1 8B 实现可以用作部署脚手架。因此,本次成就是:让 NVIDIA 针对 Nemotron 的后训练权重运行在 Qualcomm 优化过的 Llama 3.1 执行路径上,而不是向 QAIRT 添加新的 Mamba/MoE 算子栈。
Nemotron Nano 在 Qualcomm Dragonwing IQ-9075 EVK 上的定位
正如后续教程中详细介绍的那样,如果目标是简单的 BFCL 风格的智能体工具使用——选择正确的工具、填写参数、在不需要工具时选择不调用、以及发起简单的并行调用——那么为 IQ9075 量化并导出 Nemotron Nano 是很合适的。在修复了 Nemotron 原生解析器之后,它在我的小型 EVK BFCL 风格测试集上的表现超过了已量化的 QC AI Hub Llama 3.1 8B 模型。像 Ministral 3B Q4 这样的模型在这类简单任务上更弱,但在复杂的多步智能体工作流上仍然强得多。对于任何给定应用的模型选择,魔鬼都在细节中。模型卡中的聚合基准测试结果可能显示模型的优势,但为每个应用专门构建的基准测试是必不可少的!
端到端流水线
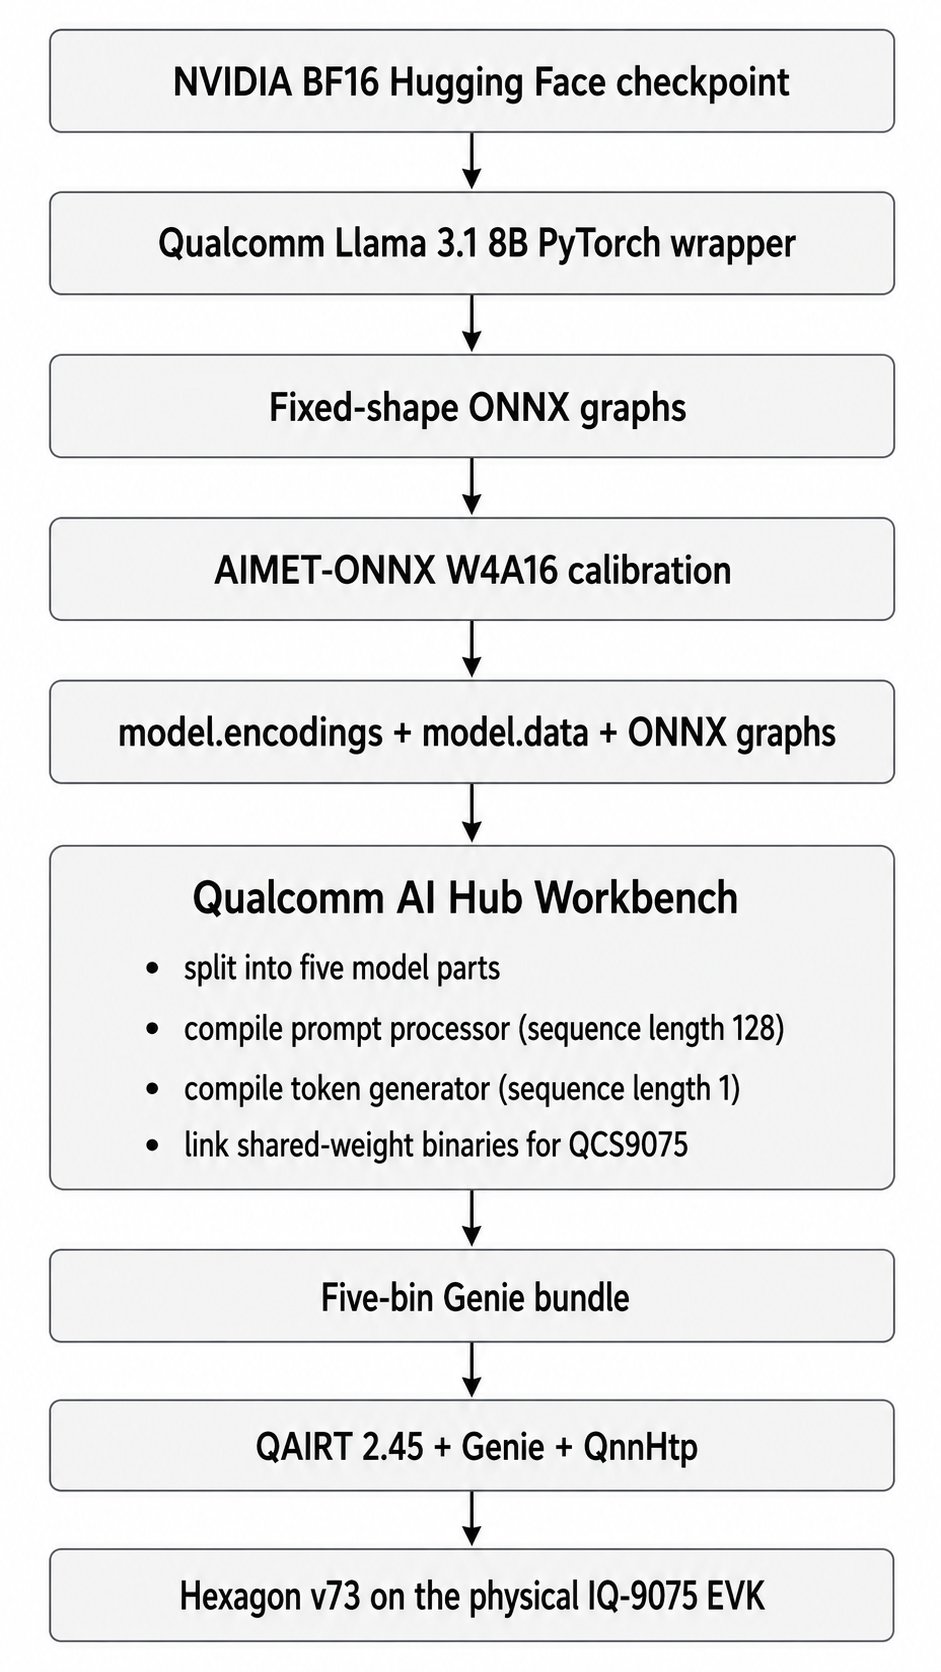
技术概念
W4A16 表示大多数权重用 4 位整数表示,而激活值保持 16 位。Qualcomm 还在需要的地方将特定张量(包括语言模型头和 KV 缓存接口)保持在更高精度。 ONNX 是 Open Neural Network Exchange 的缩写,是一种可移植的模型格式,用于以独立于训练框架的方式表示机器学习模型。在 PyTorch、TensorFlow 或其他框架中训练的模型可以导出为 ONNX,然后由不同的推理引擎和硬件工具链进行优化、量化、编译或运行。在实践中,ONNX 充当交换层:它以标准化方式描述模型计算图、算子、张量形状、权重和元数据,使部署工具可以使用模型,而无需直接依赖原始训练框架。 AIMET 是 AI Model Efficiency Toolkit 的缩写,是 Qualcomm 的开源工具包,用于在部署前压缩和优化神经网络。它通常用于量化、校准和精度恢复,帮助将大型浮点模型转换为 INT8 或 W4A16 等更低精度的格式,同时尽可能保持模型质量。在 Qualcomm 部署流水线中,AIMET 通常位于模型导出(如 ONNX)和硬件编译之间,生成量化编码和校准产物,供下游 Qualcomm 工具编译,以便在目标加速器上高效推理。 QuantSim 是 AIMET 的量化模拟计算图。它在 ONNX 中插入量化/反量化操作,使校准能够估计缩放系数,并让主机在编译前近似模拟设备上的数值行为。 提示处理器(prompt processor)与 token 生成器(token generator): 提示处理器分块消费输入,在本次部署中每次调用处理 128 个 token。token 生成器在第一个输出 token 之后每次消费一个 token。两个计算图都必须正常工作;仅验证校准形状的计算图是不够的。 KV 缓存存储先前 token 的注意力键和值。它避免为每个生成的 token 重新计算整个提示,但其维度取决于上下文长度,因此被编译进部署计算图。 HTP/cDSP: Qualcomm 的 Hexagon Tensor Processor 通过计算 DSP 和 FastRPC 传输访问。应用程序使用主机侧 QNN 库、DSP 侧 skel 库、内核 FastRPC 设备和用户态守护进程。任何一层出现故障,都可能表现为一个笼统的设备创建错误。 BFCL本次成功运行使用的硬件和软件
主机工作站
目标设备
为什么这台主机的配置异常庞大
最终的 W4A16 检查点本身只是故事的一部分。在 QuantSim 创建、ONNX 导出、校准和检查点序列化期间,主机会临时持有大型计算图结构和外部张量数据。成功的 4K 上下文运行的常驻内存达到约 174 GiB。较小的工作站也许可以完成缩小规模的冒烟测试,但在完整的4096 / 2048 / 20 运行中仍会失败。由于 RTX 5090(sm_120)的兼容性问题出现了一些弯路;本教程会解决这些问题,因为这张显卡是唯一现实可得、且能胜任此任务的”发烧级”选择。
对于内存较小的主机,请使用裸机 Linux 服务器或至少 192-256 GB 系统内存的云端 A100/H100 级别机器。编译好的部署包随后可以复制回 EVK。
准备 WSL2 和存储
在 Linux 文件系统中工作
将项目存放在 WSL 文件系统下:/mnt/c 下进行大型 ONNX 和检查点操作。跨文件系统 I/O 更慢,而此工作流会执行数百 GB 的读写。
让 WSL 能看到足够的内存
最初几次失败的运行被 Linux 杀掉了,尽管 Windows 主机有 191 GB 内存。WSL2 自身有一个更低的内存上限。 如果尚不存在,请在 Windows 侧创建此文件:规划磁盘用量
开始之前:model.data 文件、多个 ONNX 计算图、编码文件、临时归档、Hugging Face 权重、CUDA 软件包以及 pip/Conda 缓存。
创建版本对齐的主机环境
环境是本教程中最重要的可复现性细节。 我最初使用 AIMET-ONNX 2.33 和 ONNX Runtime GPU 1.22 的 Python 3.12 环境完成了量化,但部署形状的计算图输出了多语言乱码 token(™)。直接用于校准的计算图能产生正确的 token,而单独导出的 128-token 和 1-token 计算图却是错的。量化成功的提示信息并不保证检查点有效。 可用的环境尽可能与 Qualcomm 的 Llama 3.1 配方对齐,同时为 RTX 5090 保留了较新的 PyTorch 构建。创建 Python 3.10 Conda 环境
安装兼容 Blackwell 的 PyTorch
Qualcomm 针对该模型的软件包最初固定为 PyTorch 2.4.1/CUDA 12.1。该构建能识别 RTX 5090,但缺少sm_120 内核。PyTorch 警告 GPU 不兼容。
改为安装 CUDA 12.8 的 wheel:
安装 QAI Hub Models(不带 Llama extra)
不要在此环境中直接安装 Llama extra,因为它可能会将 PyTorch 降级到不兼容的版本。安装 Qualcomm 的 AIMET-ONNX 2.26 wheel
最后安装 ONNX Runtime GPU
qai-hub-models 的元数据可能会抱怨缺少普通的 onnxruntime。不要为了满足元数据而同时安装 CPU 和 GPU 发行版。两者都提供同一个 onnxruntime Python 模块,后安装的那个会悄悄替换另一个。
修复 AIMET 的 libpython3.10.so.1.0 查找问题
第一次 AIMET 2.26 运行失败并报错:
验证确切的环境
在花一小时处理模型之前先验证 AIMET
运行一个微型 QuantSim 测试
导入成功还不够。要实际调用 AIMET 的原生libpymo 路径并创建一个 QuantSim 会话:
__del__ 警告可以忽略。
量化 Nemotron
如有需要,先进行 Hugging Face 认证
接受相关模型许可证并登录:先运行一次小规模验证量化
本次运行中非致命的警告
你可能会看到:验证实际部署路径
不要只测试校准期间直接使用的计算图。要同时测试 128-token 提示处理器和序列长度为 1 的生成器:为什么这个验证很重要
使用早先的 AIMET 2.33 / Python 3.12 软件栈时,量化打印出completed successfully,且大的校准计算图能输出正确的第一个 token。然而 128-token 和 1-token 部署计算图却生成了不知所云的胡言乱语。解决办法不是增加校准样本,而是使用版本对齐的环境。
运行完整的 4K 上下文量化
model.data 文件约为 32.1 GB。
在云端编译之前验证完整检查点
在 Qualcomm AI Hub 中为 QCS9075 编译
配置 Qualcomm AI Hub Workbench
从你将用于查看任务的同一个 Qualcomm 账户获取 API token: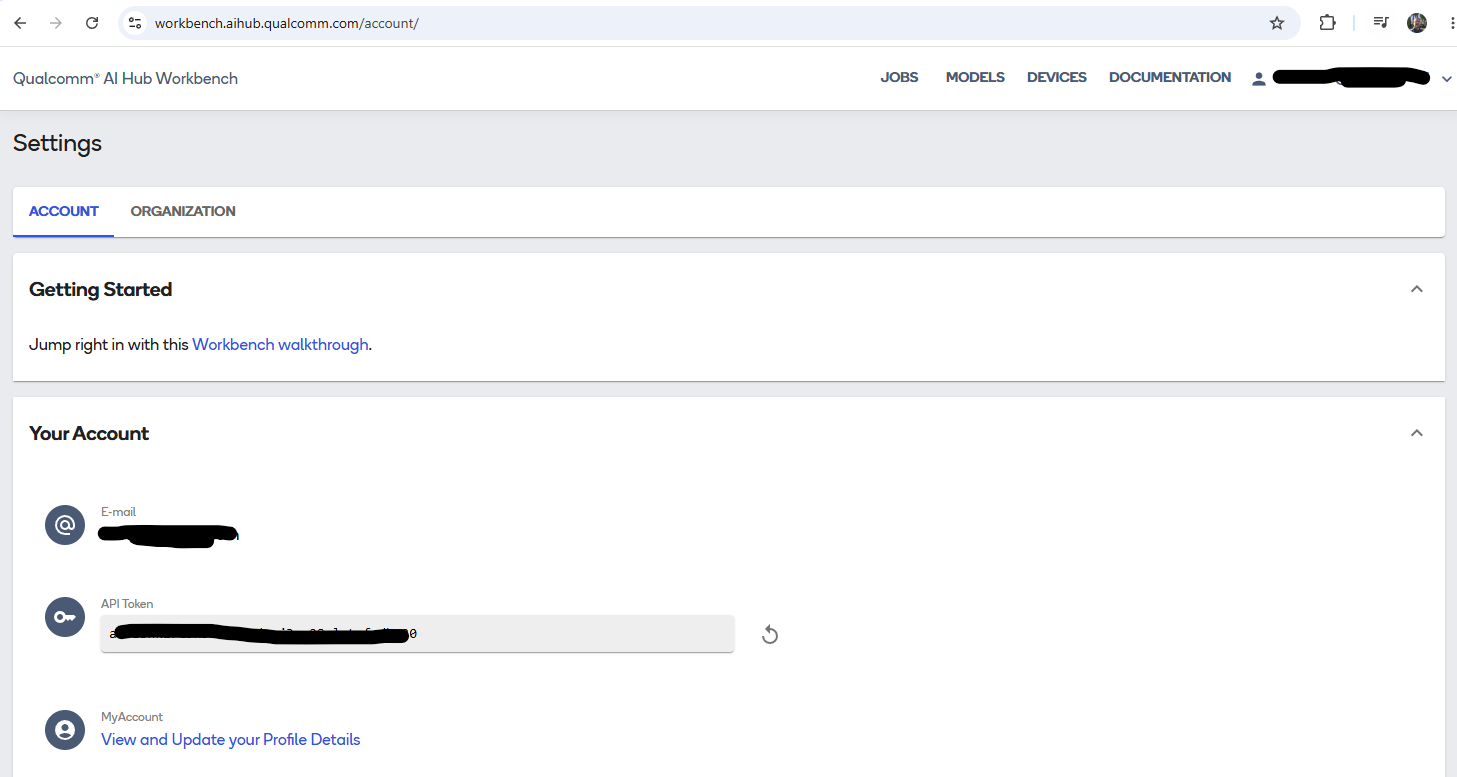
为 Dragonwing IQ-9075 EVK 导出
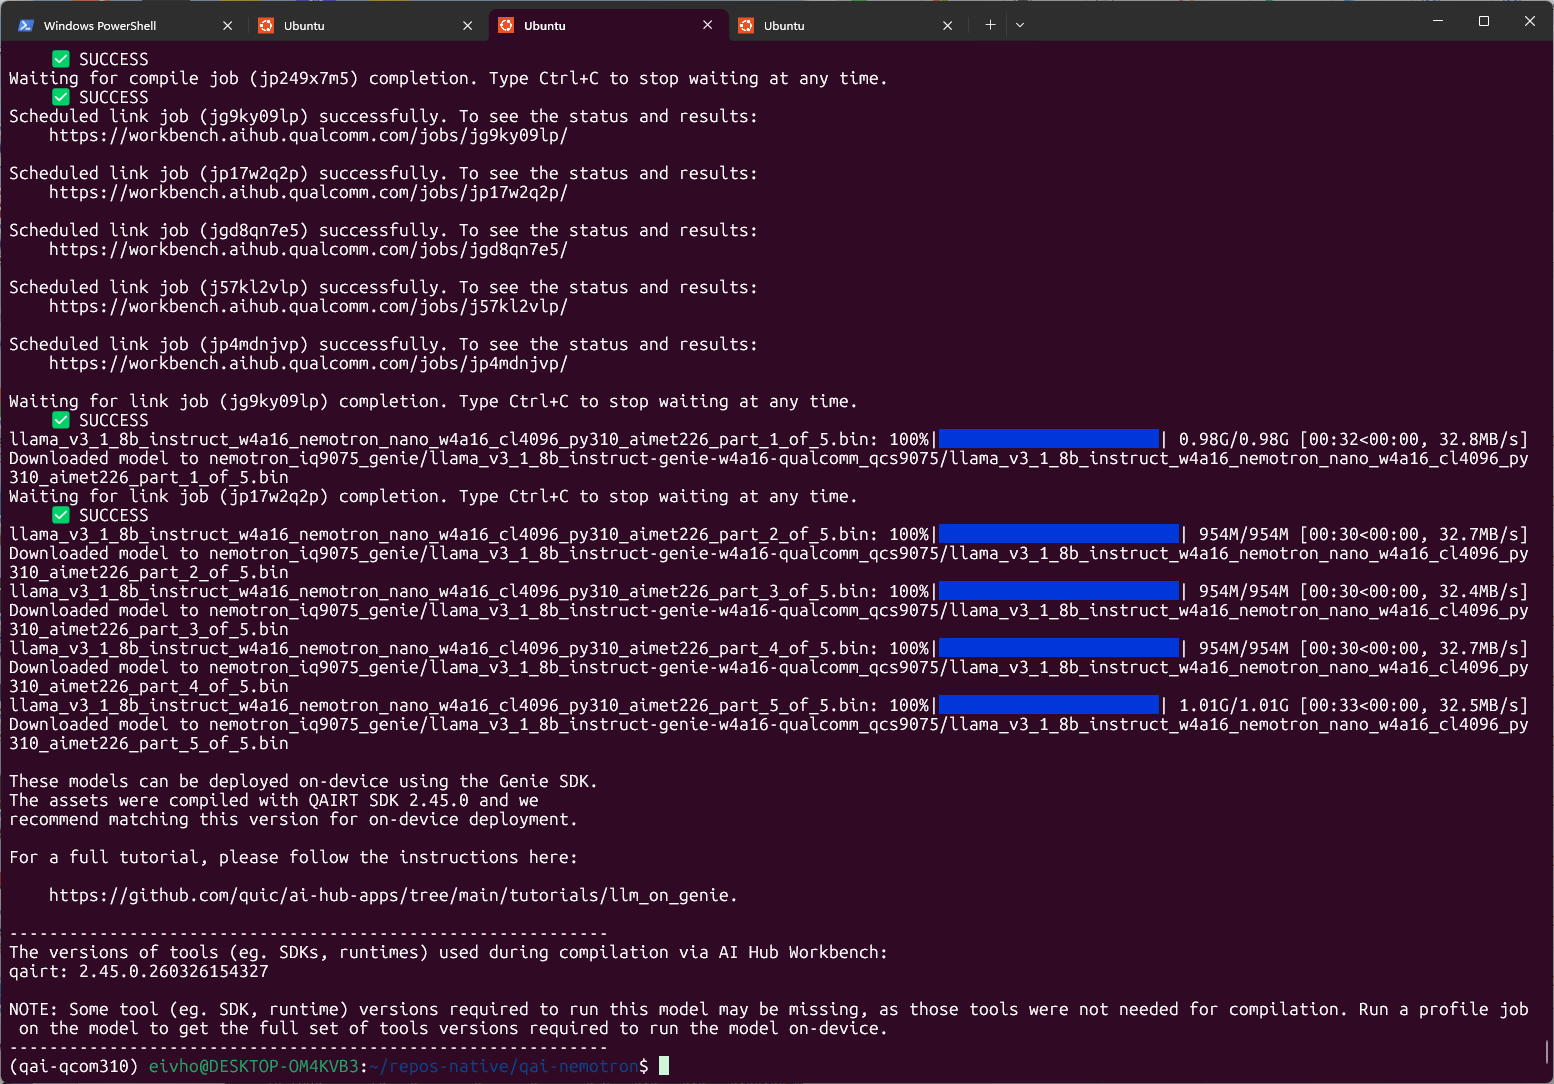
这条命令实际做什么
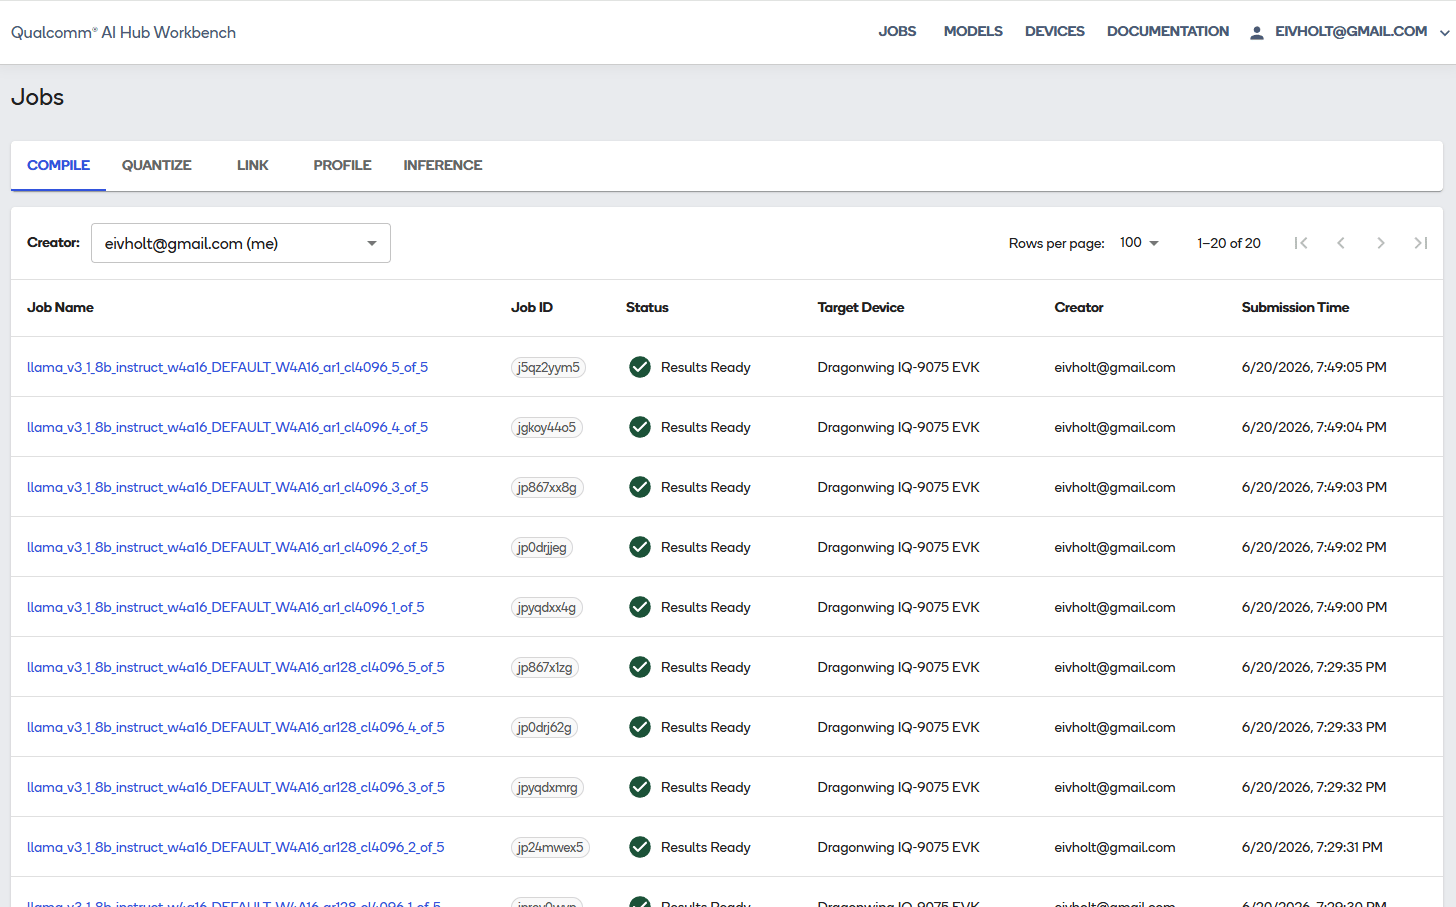
它不会将模型上传到你的物理 EVK。它将 AIMET/ONNX 产物上传到 Qualcomm AI Hub Workbench,为 QCS9075 目标编译,将它们链接为运行时二进制文件,并将 Genie 部署包下载回主机。 由于模型被拆分为五个部分且需要两种序列长度,Workbench 会创建:- 五个 128-token 提示处理器的编译任务;
- 五个 1-token 生成器的编译任务;
- 五个链接任务,用于组合对应部分并共享权重。
隐私与许可说明
此步骤会将模型衍生产物发送到 Qualcomm 的云服务。在使用专有或受限的检查点之前,请审查 NVIDIA、Meta、Qualcomm 以及组织内部的政策。检查下载的部署包
经过验证的部署包写入到:llama_v3_1_8b_instruct,因为这是用于构建计算图的 Qualcomm 实现。文件名中嵌入的检查点名称以及部署包中的权重都属于 Nemotron 检查点。
检查所需的运行时:
将部署包复制到 EVK
传输完整目录
从主机执行:.bin 文件。Genie 还需要分词器和 JSON 配置文件。
在 EVK 上安装 QAIRT
推理时 EVK 上不需要 Python 环境。Genie 是原生的 QAIRT 可执行文件。安装 QAIRT 2.45
在 EVK 上运行:/tmp 目录。
创建干净的 QAIRT 环境脚本
IQ-9075 是搭载 Hexagon v73 的 QCS9075。安装 FastRPC 并启用 DSP
理解错误 14001
我第一次运行 Genie 失败并报错:/dev/fastrpc-cdsp 仅 root 可访问。我很快在 Qualcomm 仓库中发现了这个已被报告的问题。
FastRPC 是 ARM CPU 进程与计算 DSP 之间的传输层。主机应用加载 QNN stub 库;FastRPC 与加载匹配 skel 库的 DSP 进程通信。
安装 Qualcomm FastRPC 软件包
/usr/lib 的 QNN 库与 /opt/qairt 的 DSP 库混用可能导致 stub/skel 版本错误。
将用户添加到 FastRPC 组
独立验证 Hexagon 后端
Error in saving the results 消息可以忽略。
在 EVK 上运行 Nemotron
创建格式正确的提示
使用带有真实换行符的提示文件。Nemotron 的推理模式通过系统提示控制。运行 Genie 并保存性能分析
rpcmem_android.c 的 dummy-call 消息仅供参考;运行时正在使用平台的 FastRPC 实现。
解读性能分析
成功的运行报告了:
初始化成本在常驻服务中通常只需支付一次。10.03 tokens/s 的解码速率与 Qualcomm 公布的 Llama 3.1 8B W4A16 在 IQ-9075 上的结果几乎相同,这有力地证明了自定义 Nemotron 检查点使用了预期的 HTP 路径,而不是悄悄回退到 CPU。
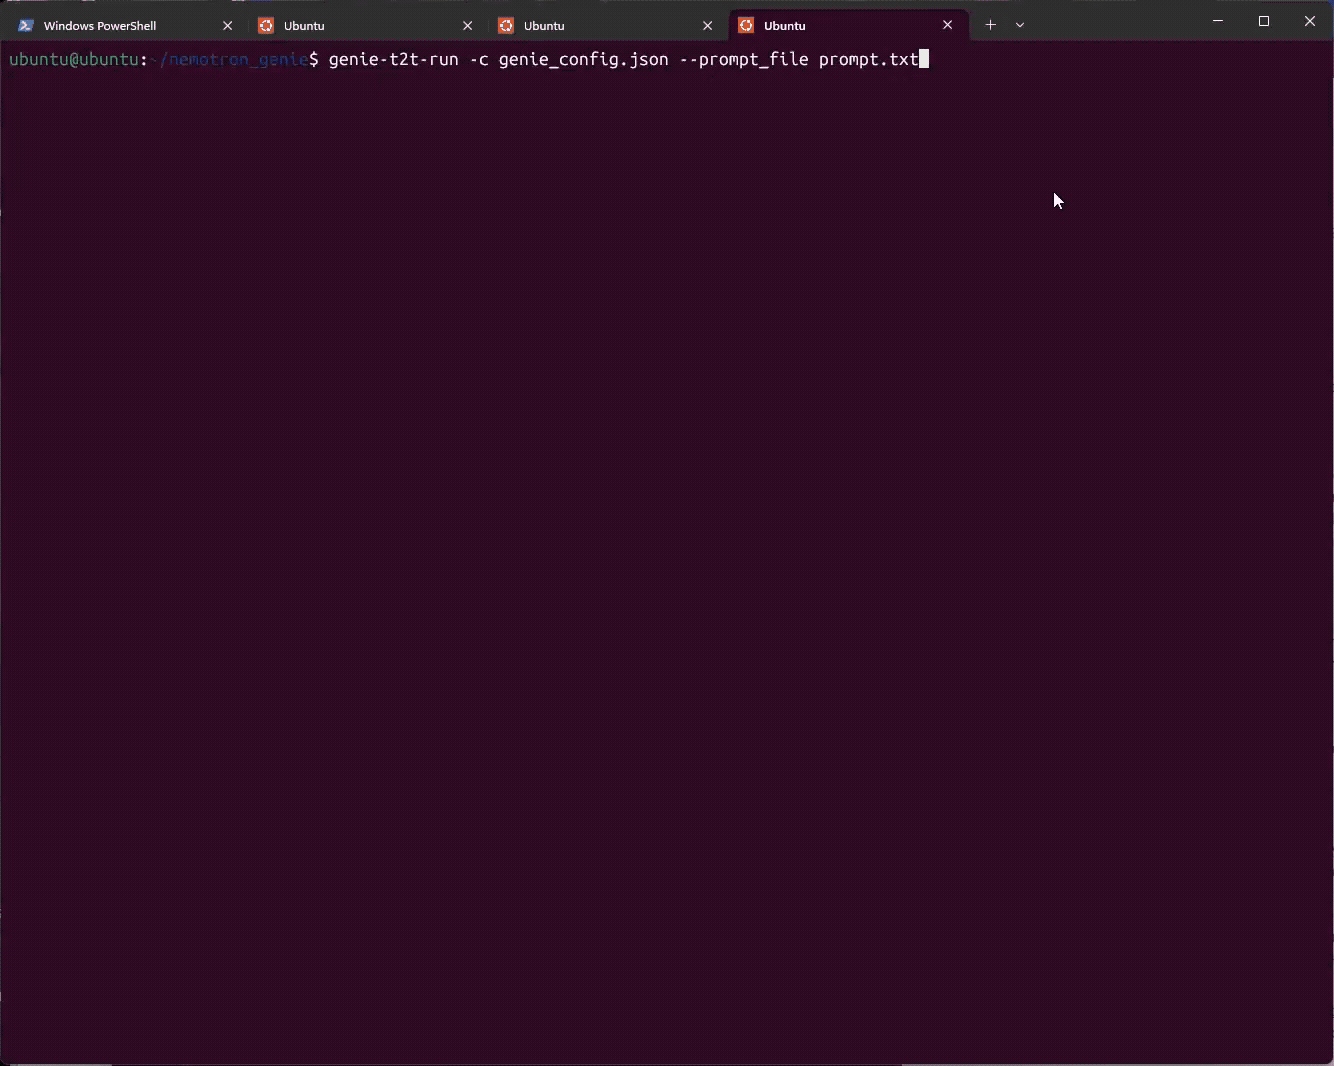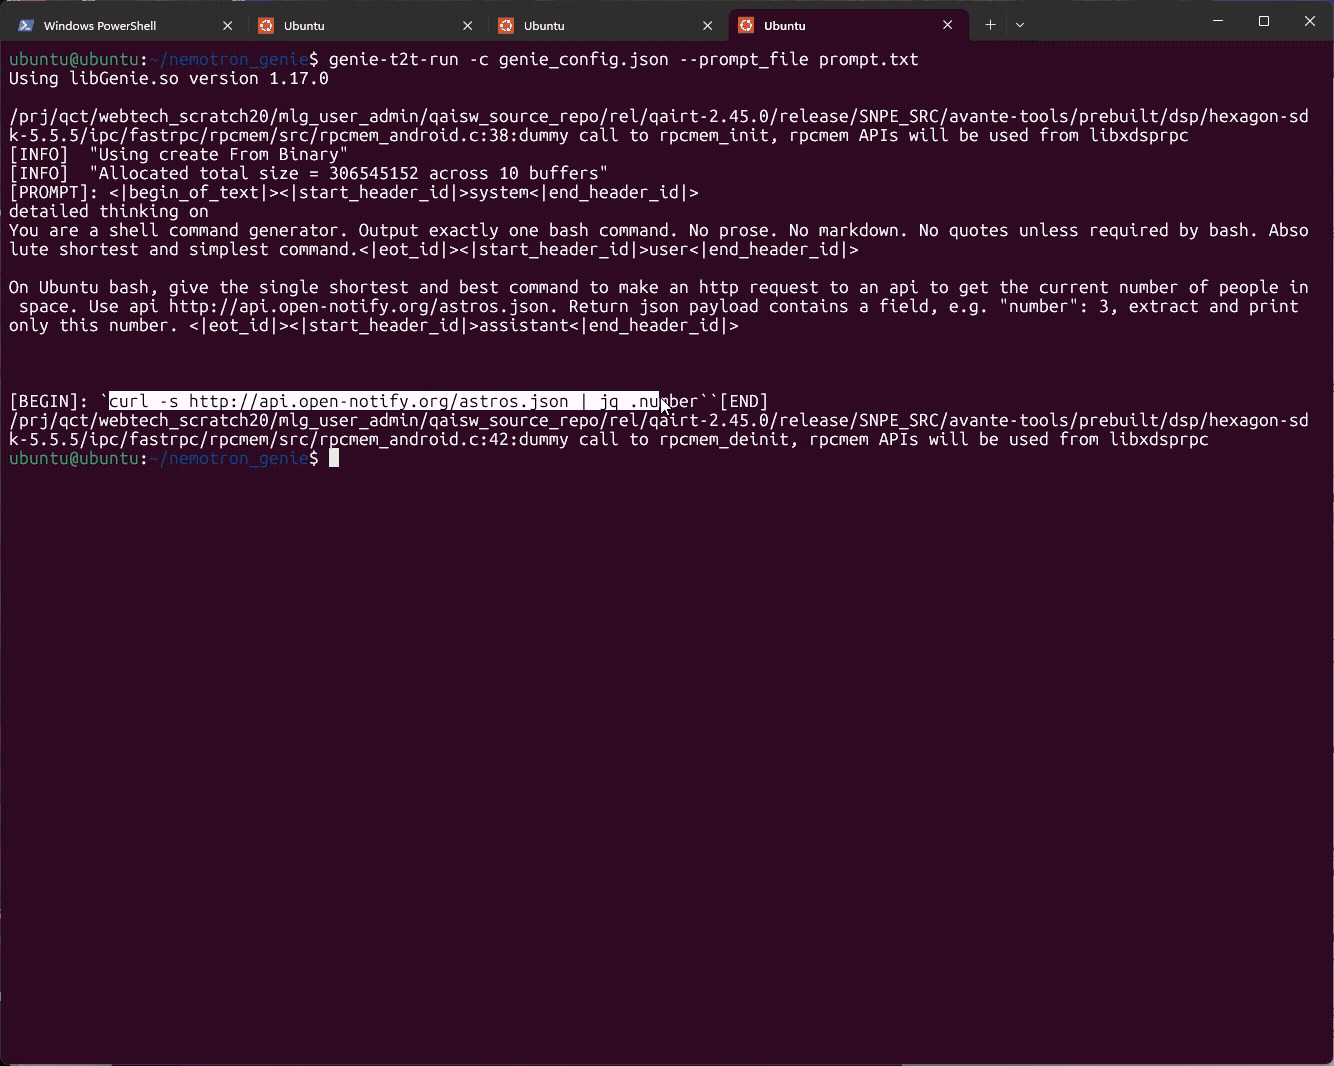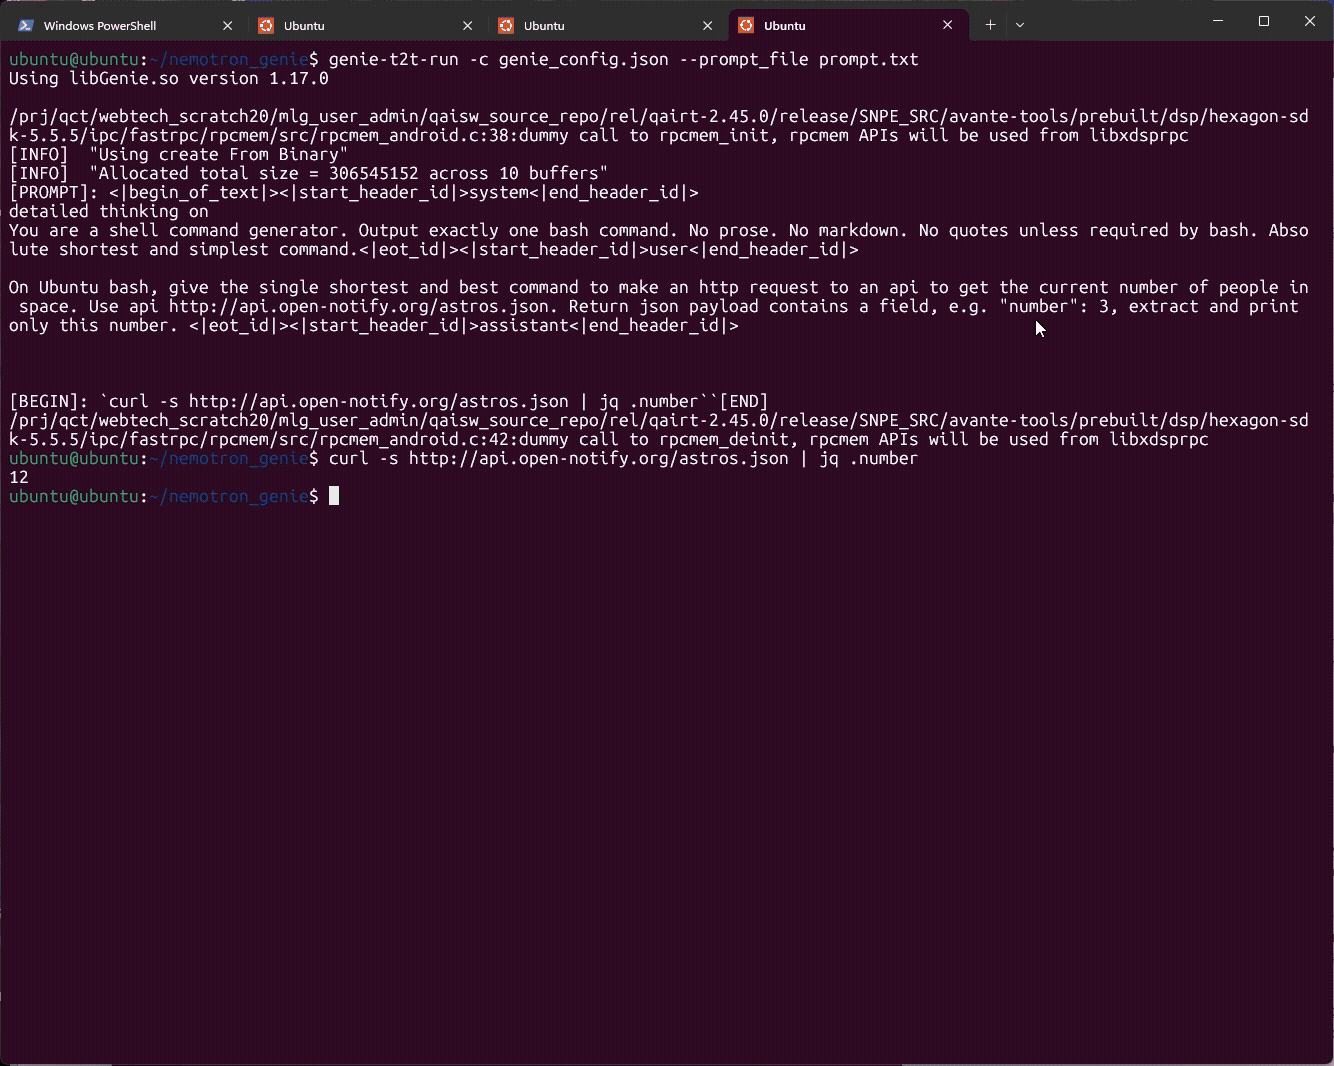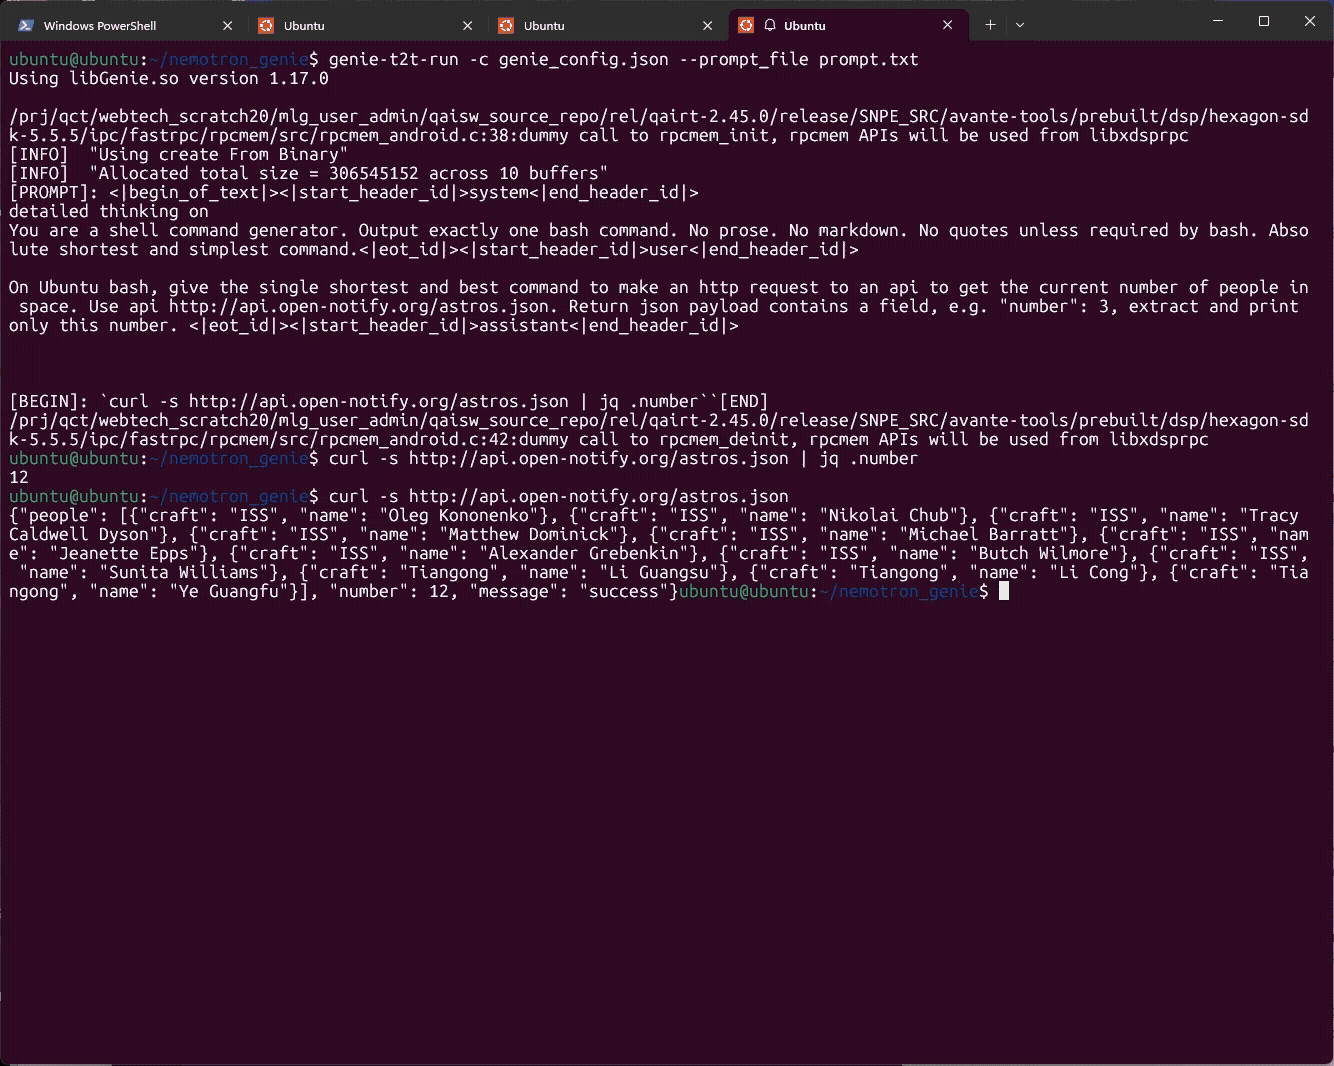
下面的简短演示在 EVK 上运行,展示了 Nemotron Nano 生成 curl 命令并提取 JSON 负载属性:
此次部署证明了什么
已证明
- NVIDIA 针对 Nemotron 的 Llama 3.1 8B 权重可以使用 AIMET W4A16 量化。
- Qualcomm AI Hub 可以为 QCS9075 编译该自定义检查点。
- 生成的提示处理器和 token 生成器可以通过 Genie/QnnHtp 在 Hexagon v73 上执行。
- EVK 以约 10 tokens/s 的速度产生连贯输出。
- 相对于 Qualcomm 原版 Llama 3.1 8B 路径,自定义检查点没有带来明显的吞吐量损失。