

Qualcomm Linux · Edge AI · Deep Dive
完整的手动流水线:每一条命令、每一个脚本、每一个设计决策的解释,从第一张照片到以 2 ms 在 Qualcomm NPU 上实时运行的 C++ 守护进程。
这是不走捷径的版本。每条命令都在这里。每个脚本都在配套文件页面上,请从那里将它们复制到所示路径中。步骤 1-6 在 Mac 和开发板上运行。步骤 7-9(NPU 部分)需要免费的 QAIRT(Qualcomm AI Runtime SDK)和一台 x86 Linux 机器。 四个阶段,让你始终清楚自己在哪台机器上操作:
你需要什么
硬件: 一台用于训练的计算机 — 本指南使用配备 Apple Silicon 的 Mac(PyTorch MPS(Metal Performance Shaders)后端),但配备 CUDA GPU(Graphics Processing Unit)的 Linux 或 Windows 同样适用;只需在训练命令中将--device mps 替换为 --device cuda。IQ-8275 EVK(QCS8300,Hexagon V75 NPU),aarch64 Qualcomm Linux,Qualcomm Linux 镜像上已预装 Python 3.x 和 onnxruntime。一个用于实时演示的 USB 摄像头。一台用于 QAIRT SDK 的 x86-64 Linux 机器(NPU 编译器仅支持 x86)。
软件: Mac 上的 Python 3 和 git。x86 Linux 机器上的免费 QAIRT SDK v2.47.0.260601。要构建实时 C++ 守护进程:一个 aarch64 交叉编译器(aarch64-linux-gnu-g++-13)。
脚本: 下面引用的所有脚本都在配套文件页面上。将每个脚本复制到其头部所示的路径。
步骤 1:构建数据集
数据集是一切的基础。你需要球拍的照片,每张照片上都绘制了边界框,还需要没有球拍的背景帧。 用于此目的的工具是 Edge Impulse Studio。其 Data acquisition 标签页允许你从连接的设备录制图像、在浏览器中绘制边界框,并以其自有格式导出。本项目中约 670 张图像就是这样标注的,无需外部工具。如果你已先完成了 Edge Impulse 快速入门,那么你已经拥有此数据集 — 直接跳到下面的导出步骤。 以 Object Detection 格式导出:在 Studio 中前往 Dashboard → Export → Object Detection format。选择能够为每个数据分割提供一个图像文件夹外加一个bounding_boxes.labels JSON 文件的格式。追求多样性:不同的距离、光照、角度和房间。包含约 15–20% 的背景帧。
最终你会得到:
x,y 位于左上角。这是 training/labels.py 期望的约定。
步骤 2:Mac 环境
创建一个工作文件夹并将脚本复制进去:步骤 3:Phase A,从零开始的 CNN(有启发性的基线)
这一步从零构建一个小型网络,仅使用你的球拍照片进行训练。它的表现会不佳。这正是重点所在。它是解释 Phase B 为何有效的对照组。3.1 预处理
.npy 数组。缓存在训练时以内存映射方式读取。在一次训练运行中将 670 张图像解码 40 次需要几分钟;而从内存映射数组读取几乎没有开销。
3.2 训练
val_IoU 列。这是诚实的衡量指标(Intersection over Union:预测框与真实框的重叠程度,0 = 完全未命中,1 = 完美)。它最高达到约 0.56。最佳检查点保存到 training/checkpoints/best.pt。
3.3 导出到 ONNX
3.4 观察它的失败
步骤 4:Phase B,微调 YOLOv8n(真正有效的那个)
4.1 环境
4.2 将标签转换为 YOLO 格式
4.3 微调
yolo/runs/paddle/weights/best.pt,mAP@0.5 ≈ 0.979。
4.4 导出到 ONNX
nms=False(NMS,即 Non-Maximum Suppression(非极大值抑制),位于 numpy 中而非计算图中)和 dynamic=False(固定 1x3x320x320,NPU 要求固定形状)。正是这两个标志让步骤 7-9 能够顺利进行。
步骤 5:浏览器中的实时演示(Mac)
--model npu 标志将接入 NPU 引擎,无需修改服务器代码。
步骤 6:在开发板的 CPU 上运行
onnxruntime。这样你能在 CPU 上获得大约 24 fps,这是使用 NPU 之前的基线。
步骤 7:为 NPU 转换模型
此步骤在 x86-64 Linux 机器上运行。NPU 编译器仅支持 x86。 从配套文件页面将这些脚本复制到 x86 机器上的npu/ 文件夹:
7.0:安装 QAIRT SDK(一次性)
选择一个有约 4 GB 可用空间的工作目录。将其导出为QW。当设置了此变量时,env.sh 文件会自动从中派生所有其他路径:
virtualenv,因为在许多没有 sudo 权限的 Ubuntu 环境中内置的 python3 -m venv 是坏的):
$QW 已在你的 shell 中导出,你无需编辑任何内容。env.sh 文件会自动从中派生所有路径:
env.sh 在配套文件页面上。
7.1:将模型和校准数据复制到 x86 机器
先在 Mac 上生成校准数据:7.2:ONNX 到浮点 DLC
7.3:量化为 A16W8
这是微妙的部分。将所有内容量化为 INT8(8 位整数)会使置信度分数坍缩为零。边界框坐标是大数字(比如 400 像素),置信度分数很小(0.87),同一个 8 位刻度无法同时表示两者。解决方案是 A16W8:将权重保持为 8 位(紧凑),但让激活使用 16 位精度以保护分数。完整解释见故事的第 6 部分。best_a16w8_htpv75.bin 是上下文二进制文件,为 HTP(Hexagon Tensor Processor)V75 提前编译。将其复制到开发板:
步骤 8:在 NPU 上运行
8.1:单次测试
开发板的/usr/lib 中已经有 QNN 运行时。你不需要从 SDK 复制任何 .so 文件。只需复制上下文二进制文件(上面已完成)以及来自配套文件页面的 run_npu16.sh。
run_npu16.sh 期望测试输入位于 /home/weston/npu/emeet2_input.raw — 一个原始 float32 NCHW 张量(形状 1×3×320×320)。在 Mac 上使用与模型训练时相同的 letterbox 预处理,从任意 JPEG 生成它:
8.2:通过常驻 C++ 守护进程进行实时流传输
对于实时使用,你需要让模型常驻:加载一次,持续处理帧。守护进程将 QNN 上下文保存在内存中,从 FIFO 管道读取帧,运行推理,并通过 HTTP 传输 MJPEG 流。 构建它需要在 x86 机器上有一个 aarch64 交叉编译器。将npu/env.sh 中的 R 设置为交叉编译器根目录(包含 usr/bin/aarch64-linux-gnu-g++-13 的目录)。
守护进程是 QNN SDK SampleApp 之上的一个小型覆盖层。先从 SDK 创建三个覆盖文件,然后应用来自配套文件页面 — 守护进程 C++ 源代码部分的差异补丁:
server.py --model npu 会自动将守护进程作为子进程启动,并通过两个 FIFO 与其通信:/tmp/npu_cmd.fifo(命令)和 /tmp/npu_resp.fifo(响应)。无需单独的守护进程启动步骤。
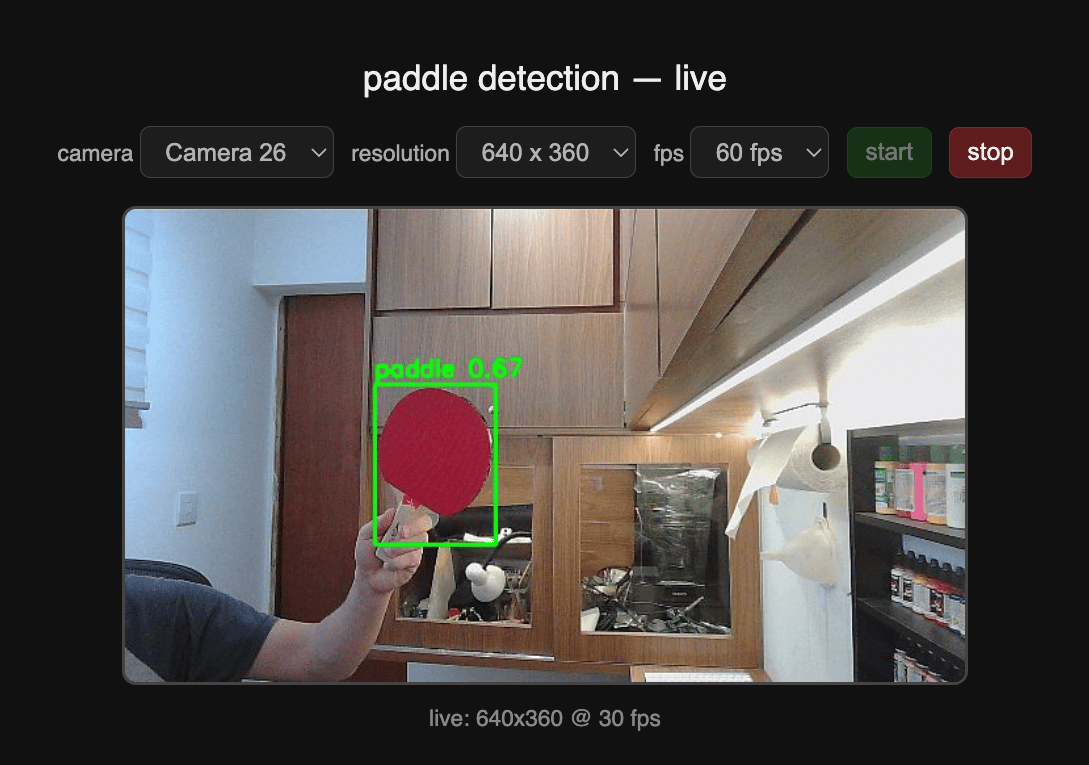
步骤 9:诚实地对比 CPU 与 NPU 基准
原始 NPU 计算快 84 倍。端到端的优势是 1.7 倍。在实现内存路径之前,NPU 版本的端到端速度慢于 CPU。307,200 次逐个数字进行的 float 到 int16 转换耗费了 30 ms。修复这一点(用向量化调用转换整帧)才带来了真实世界的性能提升。
只测量芯片计算的基准测试不是真正的基准测试。
源文件
上面引用的所有脚本都在配套文件页面上,并带有复制按钮。守护进程 C++ 源文件(
npu/daemon/main.cpp、QnnSampleApp.cpp、QnnSampleApp.hpp)没有嵌入到配套页面中,因为它们部分派生自 Qualcomm QNN SDK SampleApp。确切的修改以差异补丁形式记录在配套文件页面 — 守护进程 C++ 源代码部分中。使用 build_daemon.sh 将它们应用到干净的 SDK SampleApp 检出中。