

Qualcomm Linux · Edge AI · Computer Vision
动手构建一个实时目标检测器,在 Dragonwing IQ-8275 EVK 上运行它, 并从中榨出 2 ms 的 NPU 推理性能 — 既有困难的路,也有轻松的路。
有一件事我一直在拖延:真正使用边缘开发板上的 NPU(Neural Processing Unit,专用 AI 加速器),而不只是知道它在那里。Dragonwing IQ-8275 EVK 配备了 Hexagon V75 HTP(Hexagon Tensor Processor),据说能又快又省地运行 AI 推理。我有一个数据集、一个摄像头和一个周末。目标很简单:让开发板在实时视频中以实时速度、在 NPU 上给乒乓球拍画出边界框。 好消息:它能工作,而且确实很快。每次推理 2 ms,模型计算比 CPU 快 84 倍。有意思的消息是:到达那里经历了几次错误的弯路、一个耗掉一整天的量化陷阱,以及一个看起来不对劲的基准测试结果 — 直到我弄清楚它为什么是对的。所有这些都比单纯的成功更有用,所以这是完整的故事。 通往终点有两条路。我先讲快的那条,再讲我实际走过的那条。
第 0 部分:轻松的路径,Edge Impulse
Edge Impulse(现在是 Qualcomm 的产品)是一个正是为这类部署而构建的机器学习平台。你无需编写训练代码和管理量化流水线,而是通过浏览器 UI 操作,并下载一个可在你的开发板上运行的文件。 它最好的功能之一是数据采集和标注工具链。本项目的数据集完全是在 Edge Impulse Studio 的 Data acquisition 标签页中构建的。大约 670 张图像直接在浏览器中录制和标注,无需外部工具。你还可以以其自有格式导入和导出数据集,后来同样的数据就是这样被用于下面的手动流水线的。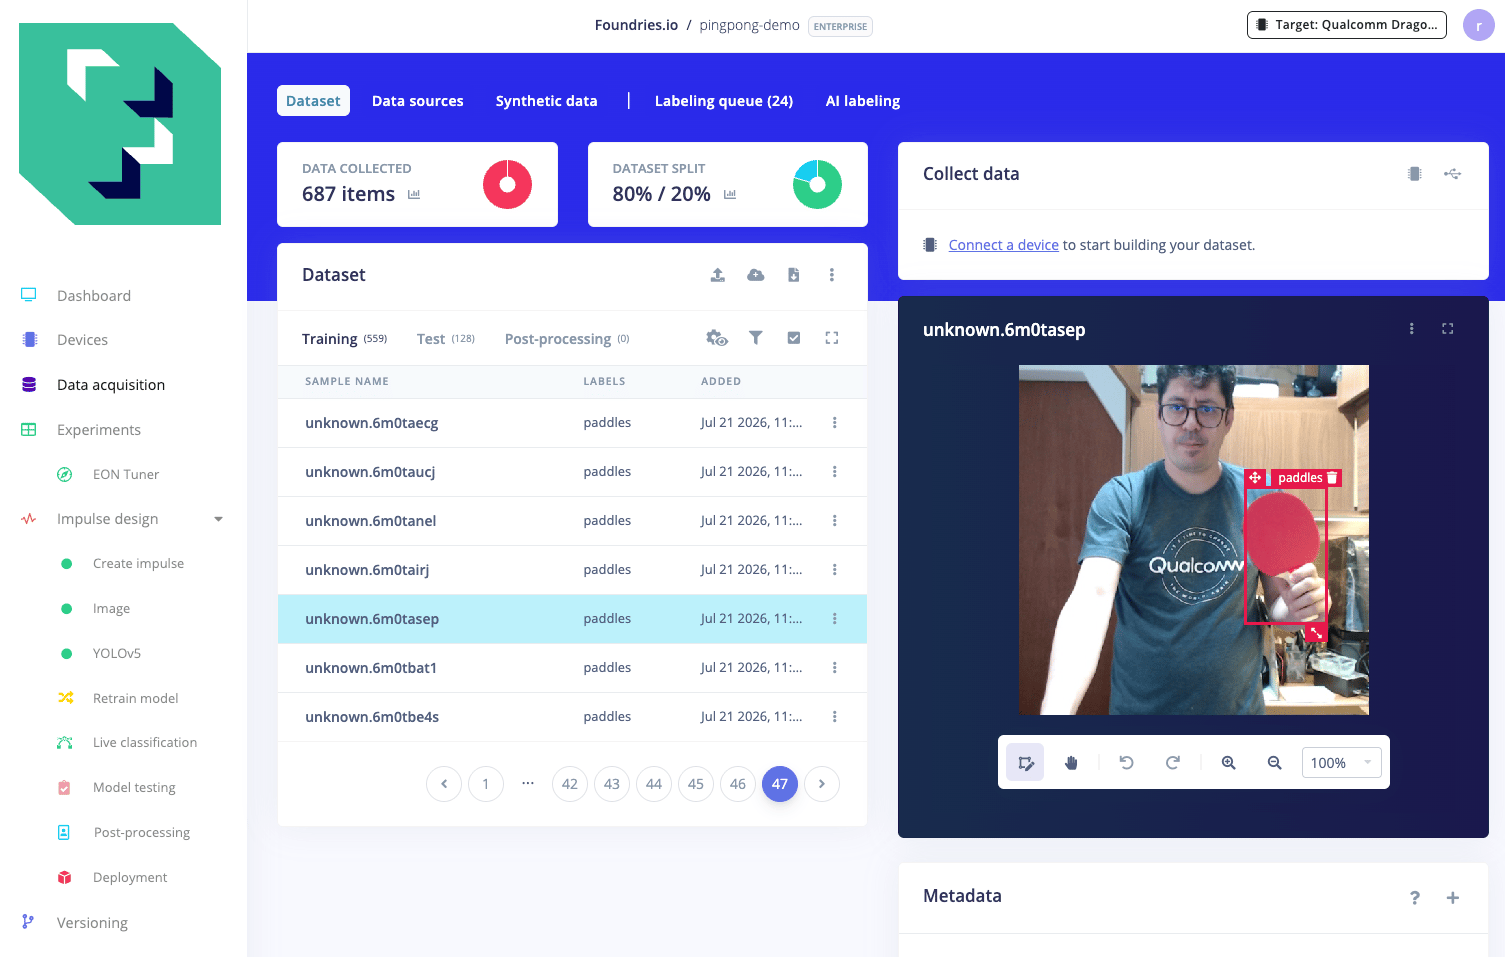
scp 之后:
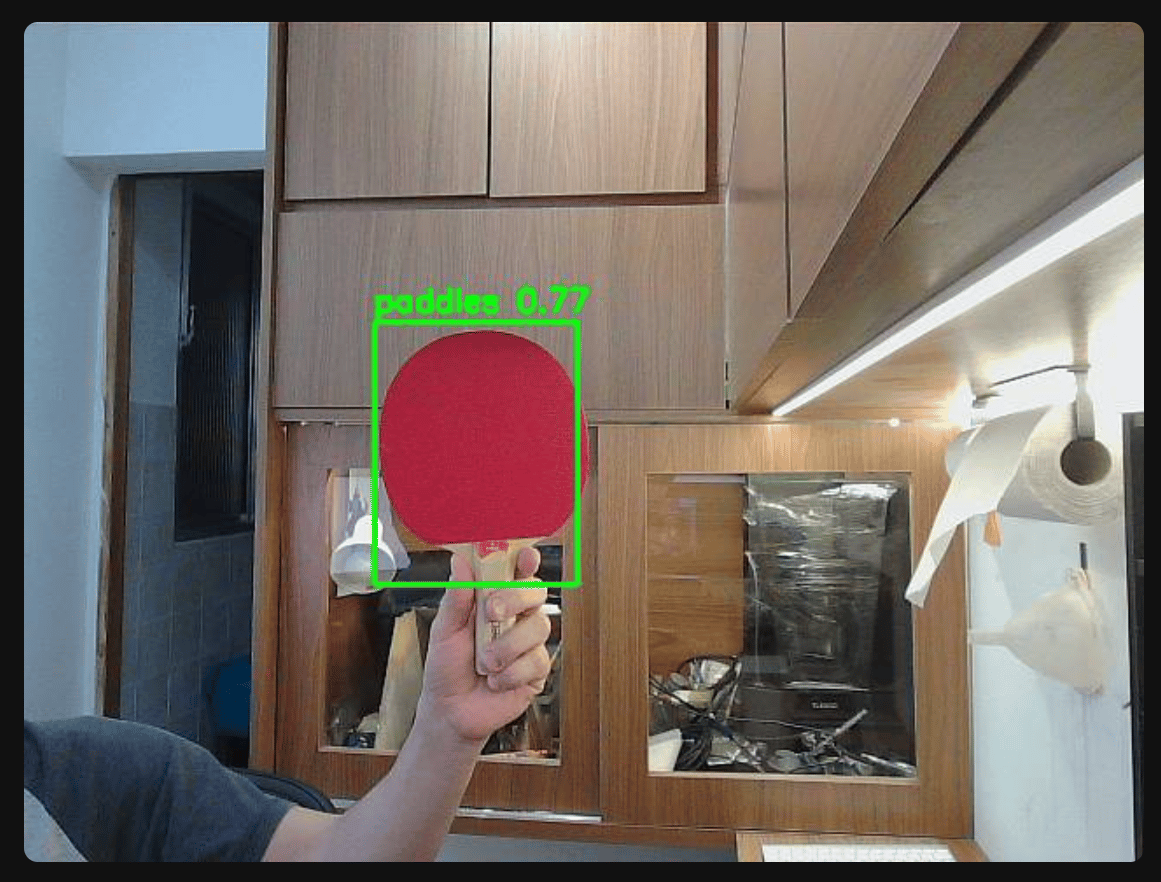
我想搞明白的部分:里面究竟发生了什么?
Edge Impulse 给我的.eim 文件包含一个量化的神经网络、一个定制的 Linux 运行时,以及一个自动将计算图放到 HTP NPU 上的 QNN(Qualcomm Neural Network)委托。在浏览器中点击四次,我就得到了下面手动流水线要花几天才能达到的相同结果。
但量化为什么重要?什么是 QNN 委托?为什么普通的 INT8(8 位整数)会悄悄破坏我模型的置信度分数?什么是”上下文二进制文件”,以及为什么 AOT 编译的版本零预热,而 .eim 首次调用要花 3 ms?
这些问题正是本故事其余部分存在的原因。
第 1 部分:数据集 — 唯一真正需要优先处理的事
模型的好坏取决于它学到的东西。这里的数据集是大约 670 张乒乓球拍的照片:不同的房间、光照水平、距离和背景。每张照片要么围绕球拍绘制了边界框,要么是完全没有球拍的背景帧。背景帧很重要。它们教会模型”这里什么都没有”是什么样子,这对检测器来说是工作的一半。 所有标注都在 Edge Impulse Studio 的数据采集界面中完成,在浏览器中一个框一个框地画。无论你走平台路线还是手动路线,这都是起点。 我不断重新领悟的一个教训是:数据集的多样性几乎总是胜过更大的模型。 第 2 部分正好说明了为什么。第 2 部分:从零构建一个大脑(以及它为何半途而废)
第一次尝试是从零构建的定制 CNN(Convolutional Neural Network,卷积神经网络):一个只有一个图像输入的小型网络,仅用那约 670 张照片训练。没有预训练,没有借来的知识。 它在与训练集相似的照片上有效:人站得较远、光线好、球拍完整可见。然后我把实时摄像头对准昏暗房间里的一张特写面孔,它什么都没返回。不是低置信度的检测。什么都没有。 我像医生一样对它进行了测试:- 改变球拍大小,从小到大:没有区别。不是尺度问题。
- 把我的脸从画面中裁掉:突然检测到了。脸才是问题。
- 调亮昏暗的图像:置信度跳升。黑暗也有害。
第 3 部分:微调预训练模型(真正有效的解决方案)
解决方案:不要从零开始。YOLOv8n(You Only Look Once,nano 变体)是一个预训练检测器,已经见过数百万张日常照片 — 各种光照、各种距离、各种场景。它理解边缘、形状、面孔和手中物体的样子。它只是不知道”球拍”这个特定的词。教它这最后一步(称为微调)只需要同样的约 670 张照片和一次短暂的训练。 同样的训练图像。同一台 Mac。同样多的我的时间。 结果:mAP@0.5 = 0.979。而且它在那张让从零模型完全束手无策的”昏暗房间里的特写面孔”照片中找到了球拍。 从零模型得分 0.56。微调后的 YOLO 得分 0.979。唯一改变的是从一个已经见过世界的模型出发。第 4 部分:实时观看
表格里的数字是抽象的。当你挥舞球拍时,一个浏览器标签页里的绿色框实时跟踪它 — 这才是证明。一个小型 Python Web 服务器打开摄像头,将每一帧送入模型,绘制边界框,并将结果作为 MJPEG 流提供。你选择摄像头,点击开始,挥动球拍。 有用的设计决策:服务器不关心正在运行哪个模型。无论是从零构建的 CNN、CPU 上的 YOLOv8n,还是最终边缘开发板上的 NPU,切换推理引擎只需一个参数。这种解耦让之后的每一步都容易得多。第 5 部分:迁移到 Qualcomm 开发板
训练留在 Mac 上(PyTorch 配合 Apple 的 MPS GPU 后端)。推理迁移到 IQ-8275 EVK。两者之间的桥梁是 ONNX(Open Neural Network Exchange),一种可移植的模型格式,开发板无需安装完整的 PyTorch 技术栈即可运行。将.onnx 文件复制到开发板,用 onnxruntime 运行。开发板的 CPU 达到大约 24 fps。流畅,但 NPU 就在旁边闲着。
第 6 部分:NPU、量化陷阱和看起来不对劲的基准测试
把模型放到 Qualcomm 的 HTP NPU 上需要 **QAIRT(Qualcomm AI Runtime SDK)**工具链:一个转换器、一个量化器和一个上下文二进制生成器。芯片通过使用紧凑的整数运算而非浮点运算来实现其速度。这个舍入过程称为量化。INT8 陷阱
第一次尝试:将所有内容量化为 8 位整数(INT8)。模型加载到了 NPU 上。它检测到了球拍。但置信度分数 — 那个介于 0 和 1 之间、表示”我有 87% 的把握这是球拍”的数字 — 在每次检测中都坍缩为零。 原因是刻度冲突:边界框坐标是大数字(比如 400、580 像素)。置信度分数是很小的数字(0.87)。强迫两者通过同一个为处理大的框坐标而校准的 8 位刻度,会将脆弱的置信度值压碎成零。 解决方案:A16W8(16 位激活,8 位权重)。将权重保持在紧凑的 8 位,但让运行中的数字(激活)使用 16 位精度。这个额外的范围保护了置信度分数。做出此更改后,NPU 立即报告了健康的 87% 检测。基准测试的意外
原始 NPU 计算:每次推理 1.74 ms 对比 CPU 上 145 ms,快 84 倍。实时流应该飞起来。 一开始并没有。端到端测量显示 NPU 版本约 57 ms/帧,而 CPU 约 42 ms/帧。计算快 84 倍的芯片正在输掉真正的比赛。 我去查了。计算从来不是慢的部分。芯片完成了它的 1.74 ms,然后坐着等待。等待有一个原因:格式转换。NPU 需要紧凑的 16 位整数作为输入。摄像头提供的是 32 位浮点数。每帧 307,200 个数字的转换在 CPU 上一个数字一个数字地进行,使用的是工具包的默认路径。那就是缺失的 30 ms。 修复:用一次向量化调用一次性转换整帧(不到 0.5 ms),把芯片想要的字节原样交给它。 修复之后:NPU:25 ms/帧 对比 CPU:42 ms/帧,端到端真正快 1.7 倍。 同样的检测,同样的绿色框,同样的置信度。快引擎终于有了与其速度匹配的道路。 我反复回味的教训是:NPU 从一开始就在计算上快 84 倍。只有在修复了一个一次喂一个数字的格式转换步骤之后,优势才显现出来。瓶颈从来不是芯片。第 7 部分:常驻守护进程
单次基准测试的运行方式 — 每次调用都重新加载上下文二进制文件 — 包含约 150 ms 的进程启动开销。对于实时视频,你需要让模型常驻:加载一次,持续处理帧。 解决方案是一个 C++ 守护进程,它将 QNN 上下文保存在内存中,从命名 FIFO 管道读取原始帧,运行推理,并写回结果,同时第二个线程编码并通过 HTTP 传输 MJPEG 流。浏览器标签页保持实时。NPU 在帧与帧之间从不卸载。 上面 25 ms/帧的数字就来自这个架构。帧通过 FIFO 到达,格式转换约 0.2 ms,NPU 运行约 1.74 ms,边界框解码,HTTP 编码器接手。端到端约 40 fps。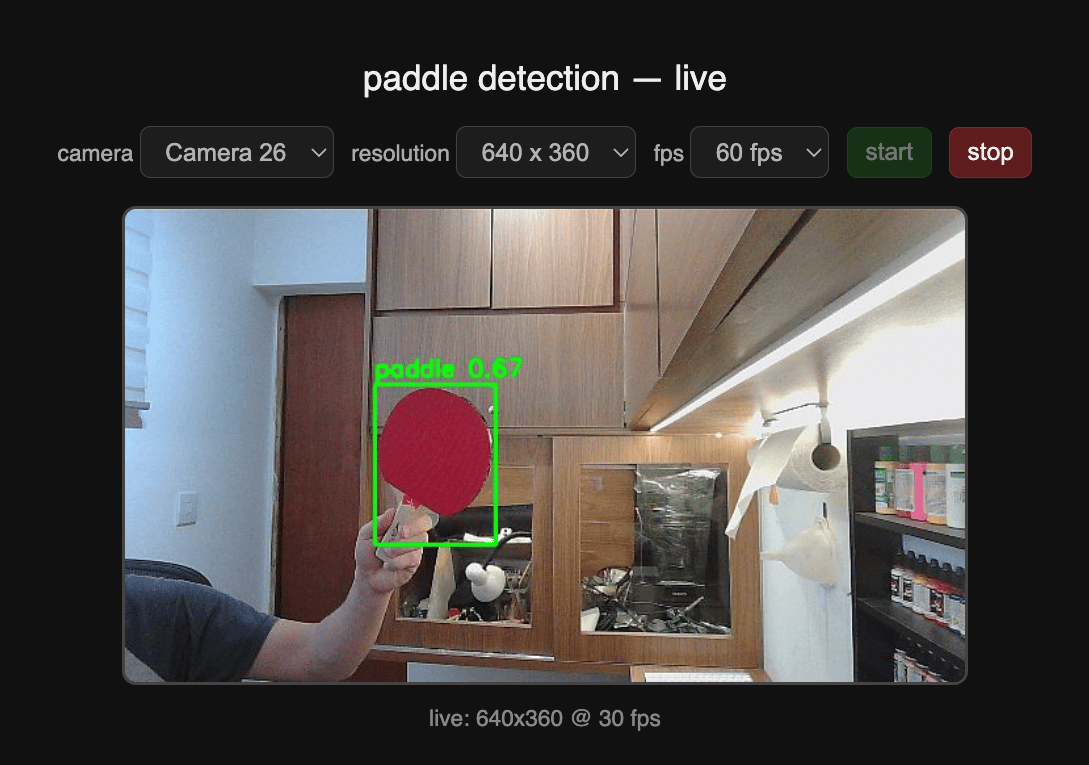
npu/ 中 — 在第 3 部分:使用 Qualcomm 工具逐步实现球拍检测中有完整介绍。另请参阅配套文件页面,其中内嵌了 env.sh 和转换脚本。
第 8 部分:对比
平台在每一个重要指标上都不相上下。两条路都是 2 ms,mAP 相差 0.001 以内。
差距在于旅程。手动流水线需要 QAIRT 工具链、量化配方、一次 A16W8 调试会话、一个 C++ 守护进程,以及大约一周时间。Edge Impulse 只需要一个浏览器和一个下午。
为什么手动路径仍然重要?因为走这条路会教会你平台隐藏起来的东西:为什么 INT8 会悄悄破坏检测器的置信度分数,为什么计算快 84 倍的芯片会输掉端到端的比赛,以及”首次调用时 JIT 编译”相对于预编译上下文二进制文件在实践中意味着什么。这些知识让你在下一个项目中成为更好的工程师,即使这个项目你用的是平台。
关于此项目是如何构建的说明
这个项目不是孤立完成的。一个 **AI 编码代理(Claude Code)**全程担任副驾驶:编写脚本、通过 SSH 在开发板上运行基准测试、解释工具链错误,并在没有任何文档的情况下找出 Edge Impulse.eim 协议正确的 UNIX 套接字消息键。最后这件事 — 通过搜索二进制文件内部的字符串找到 classify_shm — 正是代理擅长处理、而人要花一个小时的那种事情。
如果你要复现这个项目,请使用 AI 代理。QAIRT 工具链有很多尖锐的边角,其错误消息需要领域知识才能解读。它不会让困难的事情变得轻而易举。它让这些事情在一个下午而非一周内变得可以解决。
我想在开始时告诉自己的四件事
- 你的数据就是你的上限。 几百张相似的照片产生的是一个记忆者,而不是一个泛化者。更多的多样性几乎总是胜过更大的模型。
- 从预训练模型开始。 用同样的数据集和大致相同的工作量,微调 YOLOv8n 将 mAP 从 0.56 提升到 0.979。除非你已经用尽了所有预训练选项,否则没有充分的理由从零训练。
- 诚实地测量整个流水线。 NPU 计算快 84 倍却仍然输掉端到端的比赛,直到我修复了一次喂一个数字的格式转换。只测量芯片的基准测试不是基准测试。
- 瓶颈从来不在你最初猜测的地方。 不是芯片,不是磁盘,不是网络。而是 CPU 上一次一个数字的格式转换。修好道路,快引擎就会赢。
更进一步
- 通过 Edge Impulse 达到 2 ms NPU 推理的复制粘贴路径: 使用 Edge Impulse 进行球拍检测
- 每一条命令、每一个脚本、端到端: 使用 Qualcomm 工具逐步实现球拍检测
- 内嵌的 Python 和 shell 源文件;针对 SDK SampleApp 的守护进程 C++ 差异补丁: 配套文件