

有关后处理在管道中的作用背景,请参阅 IM SDK 概述。有关完整的
qtimlpostprocess 参考和自定义插件构建详细信息,请参阅 Discover SDKs → IM SDKs。qtimlpostprocess 插件的步骤。
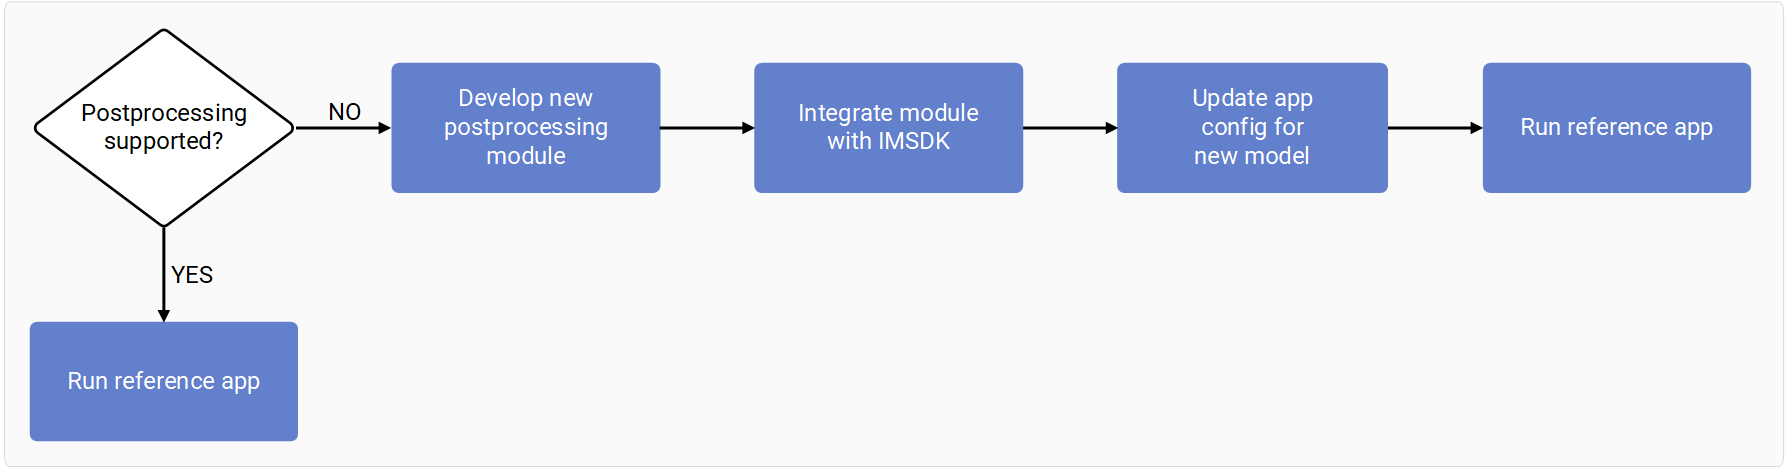
下图展示了添加您自己的后处理模型的流程,从开发和集成模型到运行参考应用程序。
AI IM SDK 管道概述
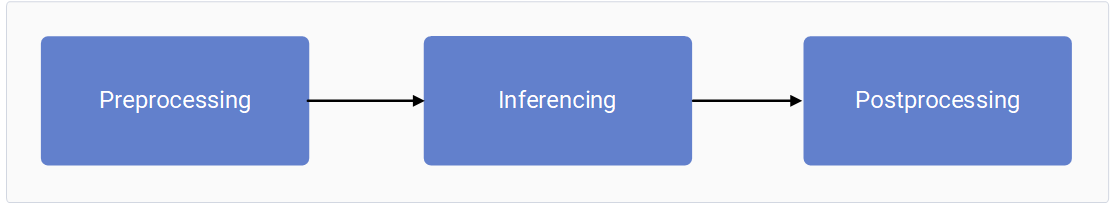
Qualcomm 智能多媒体 SDK(IM SDK)包含构建 AI、多媒体和计算机视觉管道所需的构建模块,可用于开发应用程序。 使用 IM SDK 构建 AI 工作流涉及三个关键的 GStreamer 插件。- 预处理元素:将传入的数据流转换为适合 AI 推理的张量格式。
- 推理元素:使用 AI 模型执行推理,并对输出张量应用反量化。除反量化之外,该元素不执行任何预处理或后处理。
- 后处理元素:解析输出张量并生成包含机器学习元数据的缓冲区。该元素通过以下方式之一输出元数据。
- 使用
qtimetamuxer将其附加到源流 - 直接将其流式传输到 RTSP、RTMP 或 Redis 等端点。
- 作为图像掩膜,使用
qtivcomposer叠加到源视频帧上。
示例:直接使用 ML 元数据
在以下示例中,源流在推理插件之后不再传播。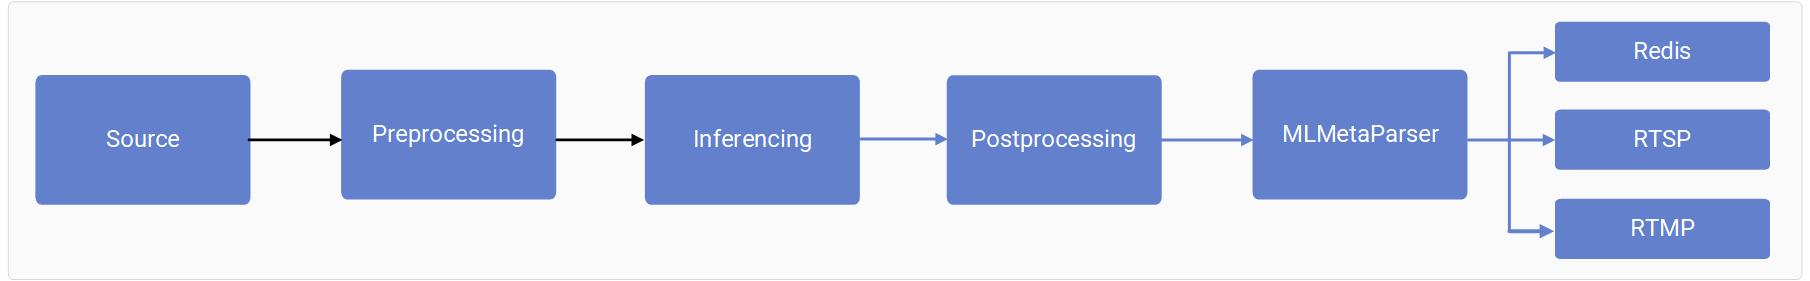
示例:将 ML 元数据附加到源视频
在以下示例中,ML 元数据被附加到源视频。 叠加层(overlay)使用附加的 ML 元数据来绘制边界框、文本和其他视觉元素。结果可以显示在屏幕上或通过网络流式传输。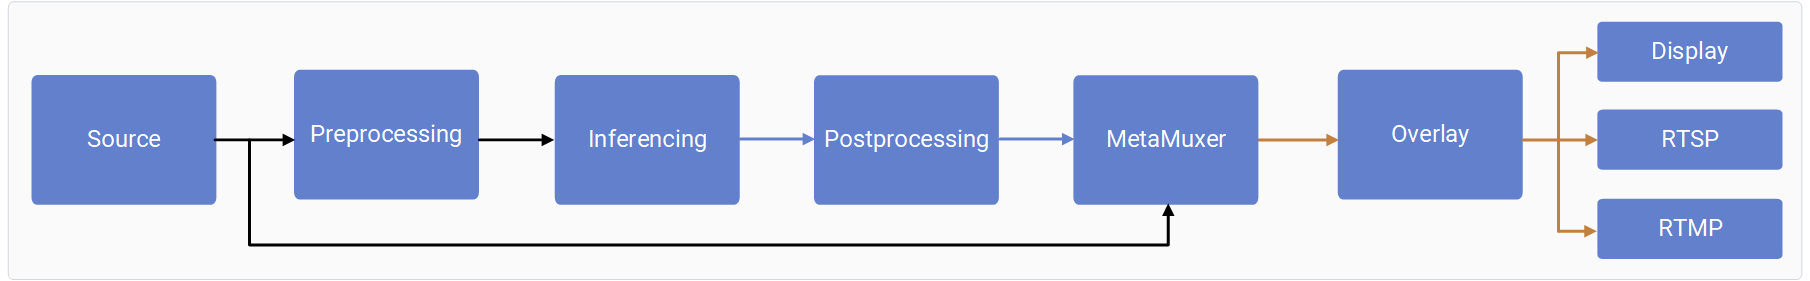
示例:将 ML 元数据转换为图像掩膜
在以下示例中,ML 元数据被转换为图像掩膜,然后叠加(blit)到源流之上。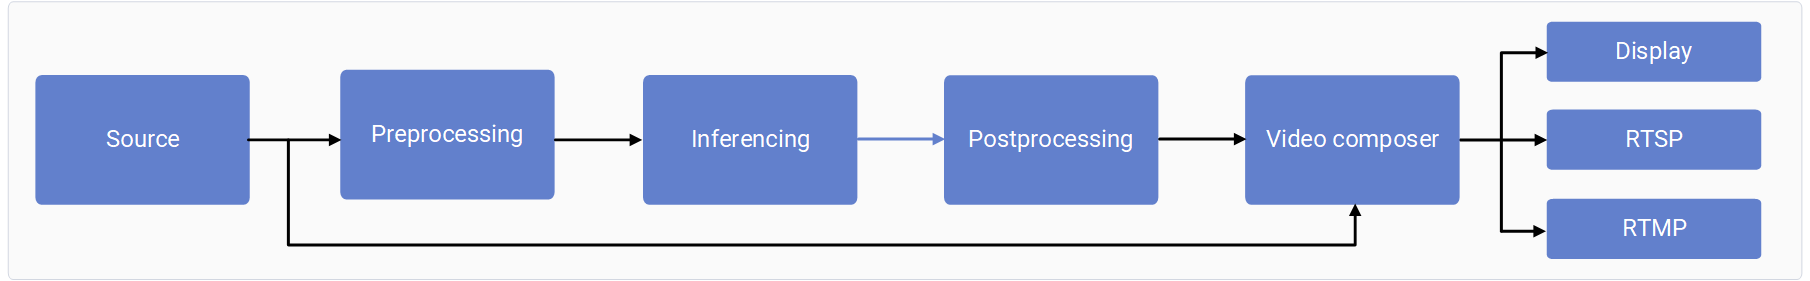
IM SDK 中的 AI 后处理插件简介
qtimlpostprocess 是一个可定制的插件,提供用于对推理插件的张量输出进行后处理的库接口。后处理库负责解析张量并输出预测结果列表。
后处理(PP)模块处理一种类型的机器学习(ML)模型。
每个 PP 模块处理一种特定类型的模型及其变体,例如所有 YOLOv8 检测模型变体。插件负责管理模块的执行、输出生成(ML 元数据或图像掩膜)、批处理、ML 暂存及其他相关任务。
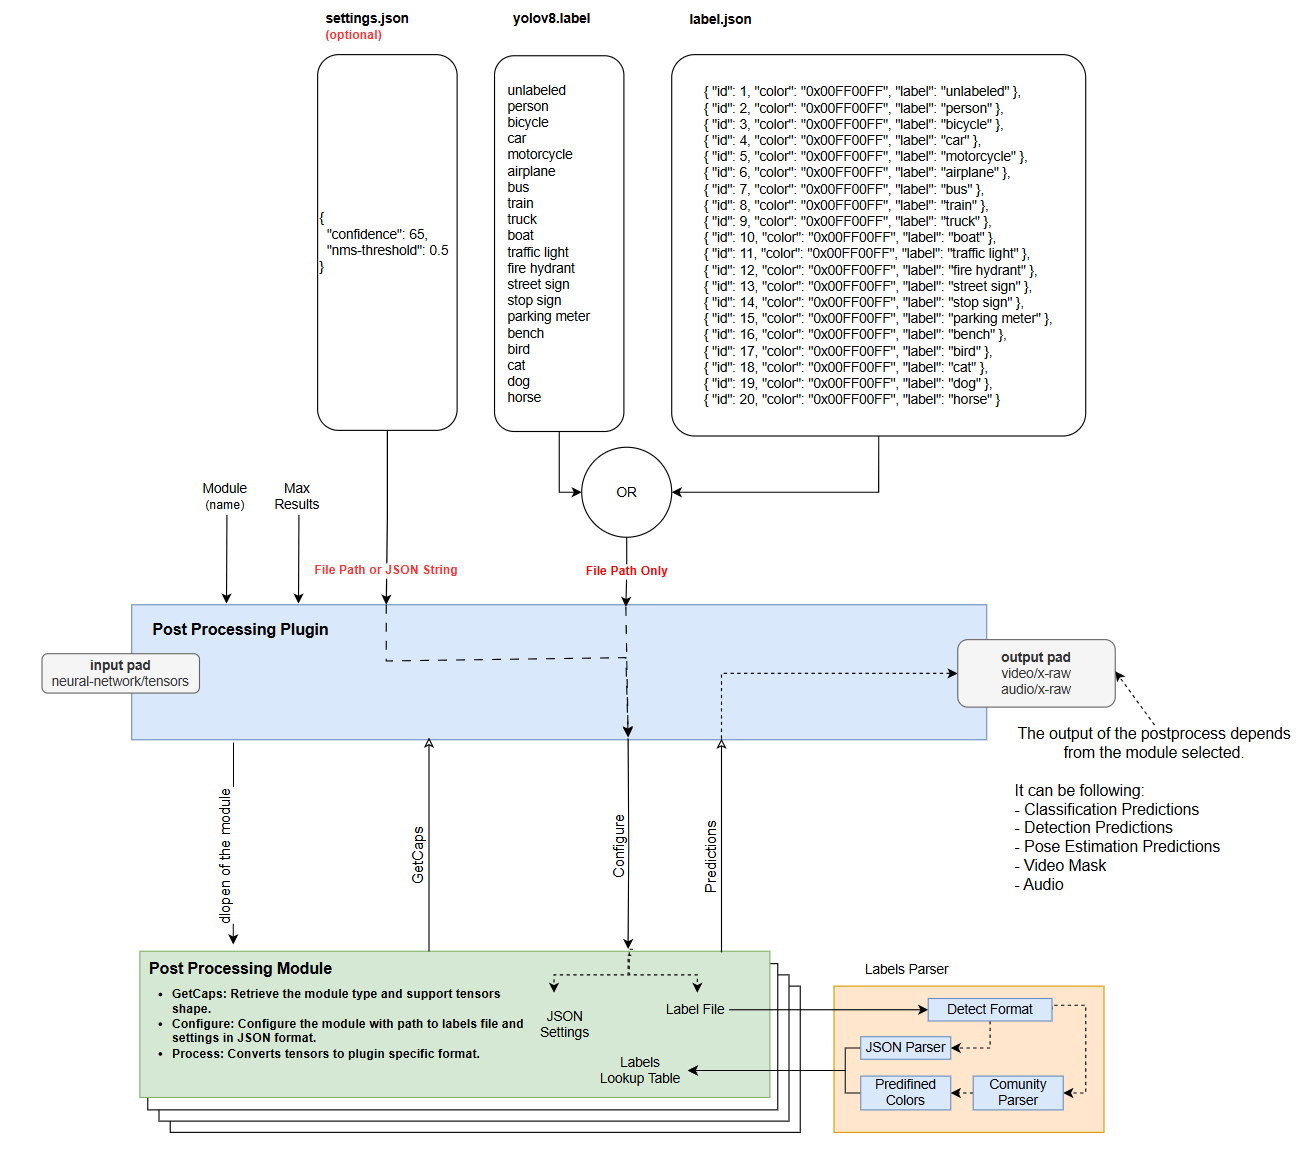
下图展示了输入、输出、后处理模块与后处理插件之间的关系。
- 目标检测
- 图像分类
- 图像分割
- 超分辨率
- 姿态估计
- 音频分类
-
文本:后处理插件将机器学习元数据序列化为文本。此元数据可以直接被其他插件使用,或使用
qtimetamuxer附加到源流。 -
图像掩膜:后处理插件可以生成带有叠加文本、边界框、点、线和其他视觉元素的图像掩膜。这是一个仅包含机器学习结果的透明帧。
例如,如果后处理类型是目标检测,插件会绘制带标签的边界框。
qtivcomposer插件随后可以将图像掩膜叠加到源视频流上。 - 张量:后处理插件可以生成张量。当下一个推理阶段需要当前推理阶段的输出张量,但张量形状不完全匹配时,请使用此格式。 例如,第一阶段生成四个输出张量,而下一阶段只需要其中三个。
- Module:(必需)后处理模块名称。此 GStreamer 属性指定如何解析张量。它不定义插件的输出类型。输出类型在管道 caps 协商期间确定。
- Settings:(可选)JSON 字符串或 JSON 文件路径。此配置仅适用于模块,而不适用于插件。由于每个模块都有特定需求,它用于向后处理模块传递任意配置。 例如,用它传递置信度阈值(confidence-threshold)、关键点、NMS 阈值和 token。
- Labels:(可选)标签文件的路径。您可以直接将标签文件路径传递给模块,使用换行分隔的标签列表、JSON 格式的标签或自定义格式。前两种格式的解析器在头文件中提供,对于自定义格式,您可以在后处理模块中实现自己的解析器。
- Results:(可选)例如,如果模型检测到 7 个结果但最多允许 4 个,则会丢弃置信度最低的 3 个结果。该功能由插件实现,因此模块开发者无需自行处理。
为自定义模型编写后处理模块
后处理模块是一个共享库,用于解析推理插件的张量输出。 后处理 GST 插件(qtimlpostprocess)负责加载和运行该模块。IM SDK 提供了种类丰富的开箱即用后处理模块:
- image-detection(yolov5、yolov8、yolonas、ssd-mobilnet、qfd、qpd、east-textdt)
- classification(mobilnet、resnet、ocr、qfr)
- pose-estimation(hrnet、lite-3dmm、posenet)
- segmentation(deeplab、midas-v2、yolov8)
- super-resolution(snet)
gst-inspect-1.0 qtimlpostprocess 查看设备上支持的完整模块列表。
以下日志显示了示例输出。
/usr/lib/imsdk/qtimlpostprocess/modules/。
后处理插件会自动检测该模块,用户即可在 GStreamer 管道中选择它。
模块和库命名
为避免后处理模块名称重复,后处理模块共享库必须遵循libml-postprocess-<module-name>.so 命名约定。
例如,YoloV8 模块的共享库必须命名为 libml-postprocess-yolov8.so。
在配置后处理插件时使用相同的 <module-name>。例如,module=yolov8。
AI 后处理模块接口
AI 后处理模块公开 C++ API。由于 C++ API 无法直接从共享库中加载,类的实例化被封装在一个 C 函数中。此机制已在头文件中实现,因此您无需手动处理 C++ 类的实例化。您只需在派生自 IModule 接口的模块类中实现以下 API。- 构造函数/析构函数:构造函数不接受任何参数,作为开发者的通用入口点。
-
Caps():以 JSON 格式返回模块类型和支持的张量维度。 -
Configure():接受标签文件路径和包含模块特定设置的 JSON 字符串。用户通过后处理 GStreamer 插件的 settings 属性提供这些设置。 -
Process():解析输入张量并根据模型输出生成预测结果。
std::string Caps()
以 JSON 字符串形式返回模块类型和支持的张量形状。张量形状不是固定的,而是在一个范围内定义,用方括号表示。 例如,[1, [21, 42840], 4] 表示第二个维度可以在 21 到 42840 之间变化。
以下代码片段是后处理模块能力(capabilities)定义的示例。该示例实现了目标检测后处理,张量格式为 FLOAT32,并支持一个、两个或三个张量输出。
支持的后处理模块类型
- object-detection
- image-classification
- image-segmentation
- super-resolution
- pose-estimation
- audio-classification
- tensor
支持的张量类型
- FLOAT32
- FLOAT16
- INT8
- UINT8
- INT16
- UINT16
- INT32
- UINT32
- INT64
- UINT64
bool Configure(const std::string& labels_file, const std::string& json_settings)
参数bool Process(const Tensors& tensors, Dictionary& mlparams, std::any& output)
参数张量输出是一种特殊情况,此时后处理插件和模块生成的是张量而非预测结果。当两个机器学习模型串联在一起,且第一个模型的输出张量在传递给下一个模型之前需要修改时,请使用此方式。如果输出张量不需要修改,则两个推理插件可以直接前后串联,无需后处理插件。
理解后处理模块输入
后处理模块输入分为两个字段:-
tensor:此字段保存推理输出张量并描述其结构。向量(vector)以条目形式表示每个输出张量。例如,对于生成三个输出张量(框、分数、类别索引)的 YOLOv8,该向量包含四个条目。
- Type:float、uint8 等。
- Name:张量名称,当两个或多个输出张量具有相同形状时用于标识。张量名称是唯一的,可保证选中确切的张量。
-
Dimensions:描述张量形状。
例如,具有三个输出张量的 YoloV8:
[1,8400,4], [1,8400], [1,8400] - Data:指向张量的指针。
-
mlparams:用于张量处理的附加参数,可能并非对所有子模块都适用。
此字段提供关于管道如何处理输入流的信息,以便在流的分辨率和纵横比与输入张量形状不匹配时提供帮助。
此字段是使用
std::any实现的字典。您必须知道预期的键及其对应的返回类型。使用std::any可确保返回值与给定键关联的类型相匹配。用法示例:支持的键- 键:“input-tensor-region” 类型:video::Region 说明:此参数指示输入张量中哪一部分填充了来自流的实际数据。其余区域被视为填充(padding)。
- 键:“input-tensor-dimensions” 类型:video::Resolution 说明:指定输入张量的大小。当后处理算法以绝对坐标生成输出时,需要用它将绝对坐标转换为相对坐标,因为后处理模块必须输出相对坐标。
生成后处理模块输出
输出是结果数组的数组。 数组嵌套是为了支持批处理用例。 如果没有批处理,则仅填充内层数组。内层数组的大小与找到的结果数量一致。 结果始终以相对尺寸表示,结果类型取决于模块类型。-
图像/音频分类
- Name:类别标签;图像/音频所属的预测类别或类。
- Confidence:类别概率或置信度分数。
- Color:用于在叠加插件中可视化的 RGBA8888 颜色。
- Xtraparams:(可选)字典形式(键/值对)的额外参数,用于从模块导出任意额外结果并传递到下游。
-
目标检测
- Left、top、right、bottom:边界框坐标。
- Name:类别标签;图像/音频所属的预测类别或类。
- Landmarks:(可选)关键点列表;例如,人脸检测模型可以在输出边界框的同时输出人脸关键点。
- Confidence:类别概率或置信度分数。
- Color:用于在叠加插件中可视化的 RGBA8888 颜色。
- Xtraparams:(可选)字典形式(键/值对)的额外参数,用于从模块导出任意额外结果并传递到下游。
-
姿态估计
- Name:类别标签;图像/音频所属的预测类别或类。
- Confidence:类别概率或置信度分数。
- Keypoints:关键点向量。
- Links:(可选)关键点之间的连接向量。
- Color:用于在叠加插件中可视化的 RGBA8888 颜色。
- Xtraparams:(可选)字典形式(键/值对)的额外参数,用于从模块导出任意额外结果并传递到下游。
-
图像分割和超分辨率
- 输出为图像帧/掩膜。
-
张量
- 张量列表。
批处理
后处理插件会自动将张量批次拆分为单个张量。 批处理由插件层处理,您无需处理批处理用例。 例如,如果批处理大小为 4,则每个批次会自动调用模块 4 次。模块辅助工具
标签和 JSON 解析器包含在接口头文件中。 您不是必须使用它们,但为方便起见提供了这些工具。 您可以使用任何标签或 JSON 解析器,但模块必须与它们静态链接。-
标签解析器:此解析器支持两种格式,接受标签文件的路径,并自动检测格式。
- 换行分隔格式:行号即类别 ID。
- JSON 格式:在此格式中,您应设置类别索引、标签和可视化颜色。 此格式更加灵活,因为您可以只传入部分类别,其余类别会自动被过滤掉。
- JSON 解析器:设置以 JSON 字符串形式传递。此工具用于解析设置,并且在 JSON 格式的情况下,Qualcomm 提供的标签解析器也使用了此实现。
日志记录
后处理模块可以将日志输出到 GStreamer 日志系统,而无需直接依赖 GStreamer。 构造函数会向模块传递一个日志对象。 该对象与 LOG 宏配合使用,可将日志直接输出到 GStreamer 日志。 支持的日志级别包括:Error、Warning、Info、Debug、Trace 和 Log。 LOG 宏:在主机上编译后处理模块
前提条件- Ubuntu 22.04 或 Ubuntu 24.04 主机。
-
安装所需工具。
-
从 CodeLinaro 下载所需的
.h和.cc文件。 -
将 IM SDK 头文件和模块源文件放在同一个文件夹中。
-
创建
CMakeLists.txt文件。例如: -
创建工具链文件,例如
aarch64-toolchain.cmake。例如: -
配置并构建模块。
部署和测试后处理模块
-
在主机上,设置用户环境变量:
- 下载所需的脚本和构件。
-
将模块部署到目标设备。
-
在主机的终端中运行以下命令,将模块传输到目标设备。
-
在主机的终端中运行以下命令,通过 SSH 登录目标设备。
-
出现提示时,输入密码:
oelinux123。 -
在 QLI 目标设备上(SSH 登录后)运行以下命令,以写权限重新挂载
/: -
在目标设备上(SSH 登录后)运行以下命令,将模块复制到 GStreamer 插件目录:
-
在主机的终端中运行以下命令,将模块传输到目标设备。
-
在目标设备上运行 GST inspect,确认您的模块出现在受支持的模块列表中。
您应能在受支持的模块列表中看到您的后处理模块及其支持的张量形状。
-
下载模型、标签和媒体文件以运行 GStreamer 管道。
- 下载 yolox.json。
-
将
yolox.json文件复制到目标设备。 - 下载 video1.mp4。
-
将
video1.mp4文件复制到目标设备。 - 下载 yolox_quantized.tflite。
-
将
yolox_quantized.tflite文件复制到目标设备。
-
拥有后处理模块后,构建 GStreamer 管道。
使用
qtimlpostprocess插件的 module 属性选择您的后处理模块。
- 管道使用离线视频作为源。
- 管道使用 v4l2h264dec 解码器将视频解码为 YUV 格式。
-
qtimlvconverter插件对 YUV 帧进行预处理。 -
qtimltflite插件使用 LiteRT YOLO-X 模型运行推理。 - 后处理插件加载 YOLO-X 模块并传入 JSON 格式的标签文件。
-
管道在 Wayland 上显示结果。