

- **您将如何准备模型?**针对目标硬件进行转换、量化、编译或微调。
- **您将如何运行推理?**即在设备上执行模型的运行时或集成路径。
选择您的旅程
使用下面的流程图找到适合您应用程序的路径。它会引导您判断是否已有模型、如何准备模型(紫色)以及如何运行推理(蓝色),然后链接到相应的指南。每个高亮的方框都可以点击。端侧生成式 AI 的可用性取决于您的 Qualcomm Linux 版本。有关当前支持状态,请参阅 GenAI 工作流页面。
AI 架构
下图展示了 Qualcomm 平台上的 AI 应用程序开发架构。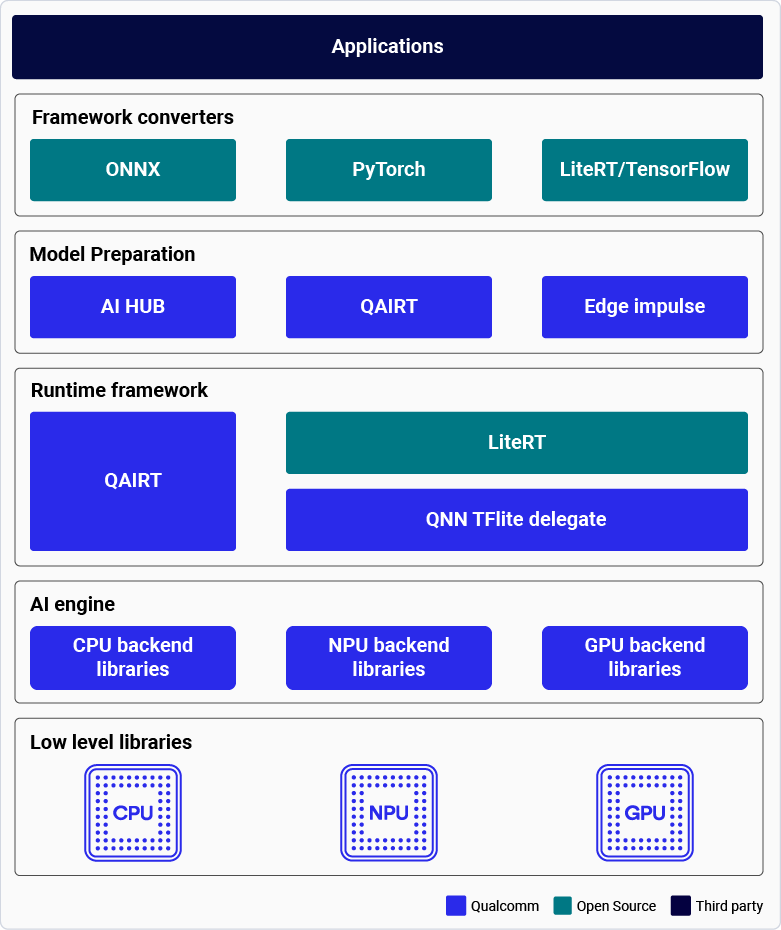
准备您的模型
在模型能够在 Qualcomm 硬件上高效运行之前,需要先将其转换为可执行格式,并且针对 Hexagon NPU(HTP)量化为受支持的精度。(LiteRT 模型是个例外:它们可以直接通过 AI Engine Direct delegate 运行。)请选择与您的起点相匹配的准备工具。运行推理
模型准备完成后,选择在设备上执行它的方式。您选择的运行时取决于您使用的语言、模型格式,以及是否要构建完整的摄像头/视频管道。正在构建机器人应用程序?Qualcomm® Intelligent Robotics(QIR)SDK 在这些运行时之上增加了基于 ROS 的模块和硬件加速节点。
AI 硬件
Qualcomm 平台包含以下用于 AI 推理的硬件加速器:- Qualcomm Kryo™ CPU —— 具有一流能效的高性能 CPU。
- Qualcomm Adreno™ GPU:为 AI 工作负载提供功耗与性能的平衡,通过 OpenCL 内核加速。也用于模型的前处理和后处理(例如,IM SDK 在 GPU 上执行缩放、颜色转换和叠加)。
- Qualcomm Hexagon™ Tensor Processor(HTP):也称为 NPU/DSP/HMX。针对低功耗、高性能 AI 推理进行了优化。为获得最佳性能,请将预训练模型量化为受支持的精度。