

基本排查
基本排查涉及应用层面的基础技术。在出于教育和学术目的使用 Qualcomm 开发套件开发应用时非常有用。基本排查可应用于无需 root 访问权限即可运行 Qualcomm® Linux® 的设备。 对于更复杂的问题,请参见高级排查。分析用户空间和内核跟踪
Function tracer(ftrace)、Trace Compass 和 LTTng 等工具常用于在 Linux 上分析跟踪数据以排查性能问题。
您可以使用
-llttng-ust 和 -g -finstrument-functions 编译应用,以显示函数调用栈。
例如,运行以下命令进行编译:
aarch64-qcom-linux-gccaarch64-qcom-linux-g++
捕获 LTTng-UST 跟踪
要使用 LTTng 捕获跟踪,请按以下步骤操作:- 要使用
liblttng-ust-cyg-profile.so显示应用的调用栈,请使用以下命令创建名为 my-session 的会话:跟踪数据位于/tmp/my-trace。 - 按以下顺序运行命令以捕获跟踪:
- 运行程序时预加载
liblttng-ust-cyg-profile库:
加载 LTTng 跟踪
- 要在 Trace Compass 中加载和可视化 LTTng 跟踪数据,请使用安全复制协议(SCP)或类似工具将跟踪数据从目标设备传输到主机。请确保在命令中指定目标 IP 地址。示例命令如下:
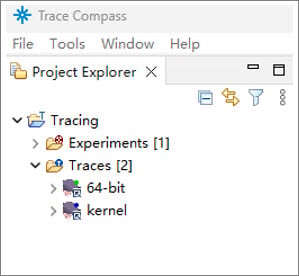
- 在主机上使用 Trace Compass 加载 LTTng 内核和 UST 跟踪。在 Trace Compass 工具中,使用 File 菜单选项打开跟踪。注意 截图仅供参考。截图中显示的目录结构可能因 Trace Compass 工具版本而异。
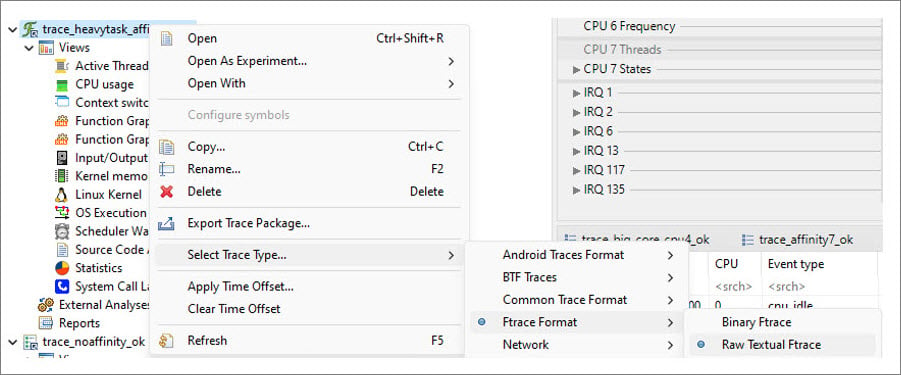
- 要选择跟踪类型,请右键单击跟踪,然后选择 Select Trace Type > Ftrace Format > Raw Textual Ftrace,如下图所示:
- 在 Trace Compass 中安装 ftrace 分析所需的附加组件。转到 Menu > Tools > Add-ons,并选择 Trace Compass ftrace。注意 建议更新 Trace Compass 首选项。要打印与原始 ftrace 匹配的时间,请将 Tracing–Time Format 更改为 TTT(epoch 秒数)。
- 要在一个视图中显示内核和 UST 跟踪,请创建 Experiments 并添加两个跟踪。
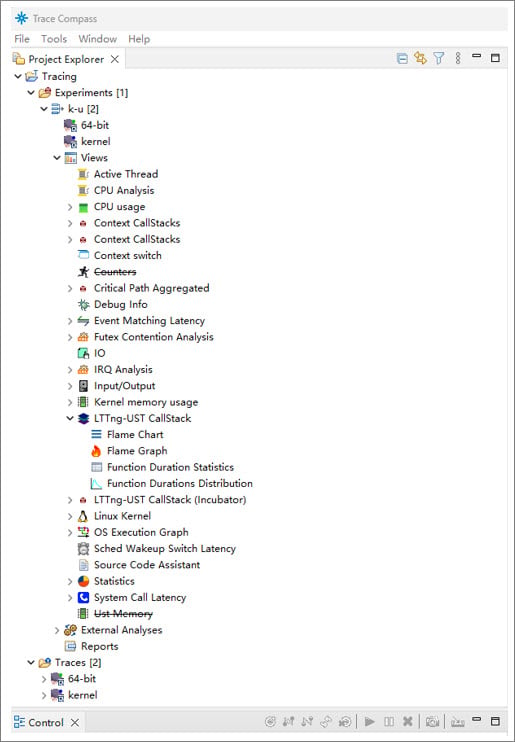
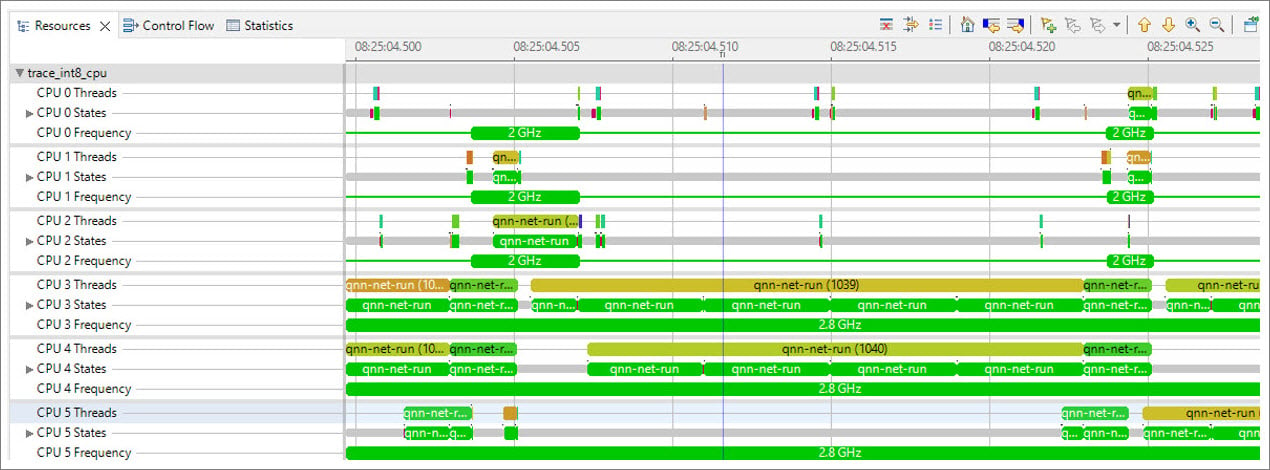
- 选择 Views > LTTng-UST-CallStack > Flame Chart and Views > Linux Kernel > Resources。Trace Compass 可以显示内核资源和用户空间应用函数调用栈,如下图所示:
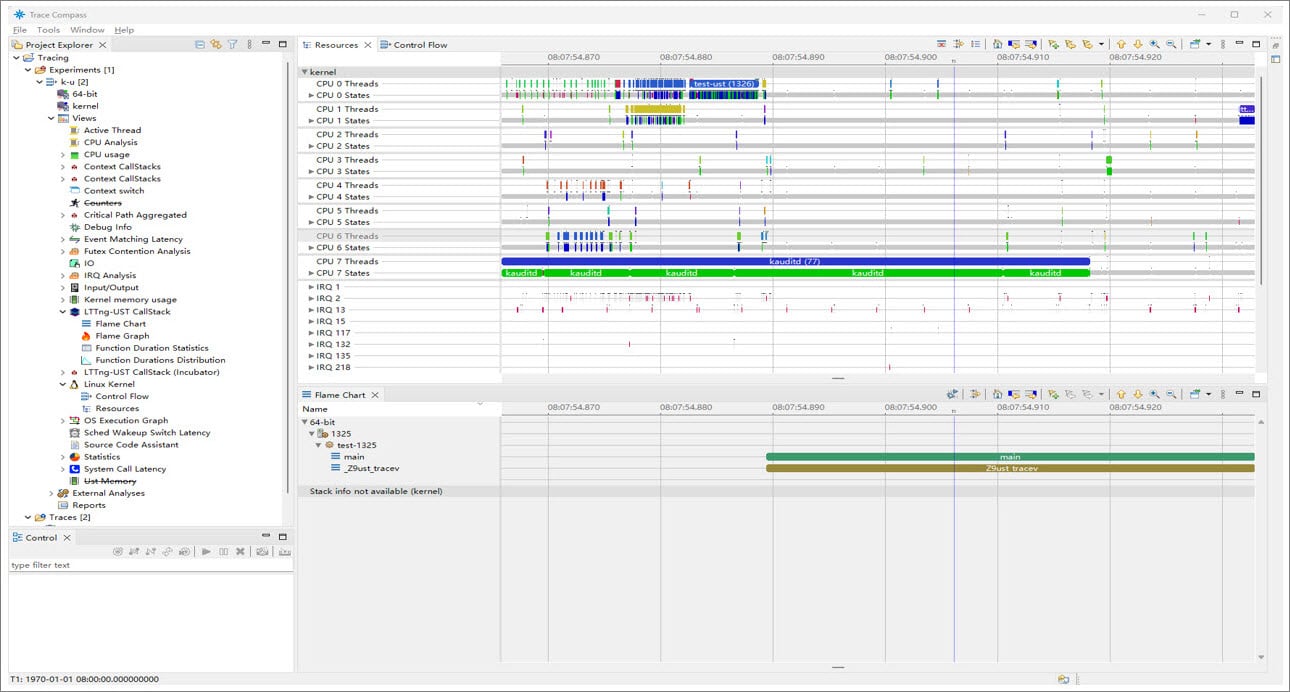
- 按照步骤 6 打开 CPU 频率的跟踪。选择 Resources 面板和在指定 CPU 上运行的进程的 Timeline 视图。CPU 频率线中有一个频率数字。下图显示 CPU0 到 CPU2 运行在 2 GHz,CPU3 到 CPU5 运行在 2.8 GHz。
监控用户空间应用的 CPU 消耗
可以使用 top 和 htop 等多种 Linux 实用工具监控 CPU 使用情况。Top
Top 是一款检查应用 CPU 使用情况并显示总体 CPU 使用率的工具。在八核平台上,任务的 CPU 消耗可以从 0% 到 800%。 要设置终端环境以运行 top,请在设备上运行以下命令: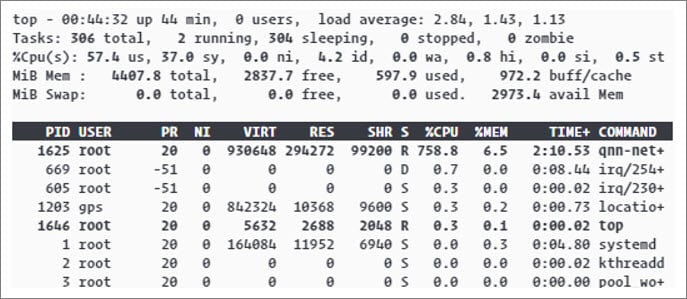
htop
htop 显示每个核心的 CPU 使用率以及每个进程的总体 CPU 使用率。要在构建中编译 htop,请参见编译性能工具。 要为 htop 设置终端环境,请在设备上运行以下命令: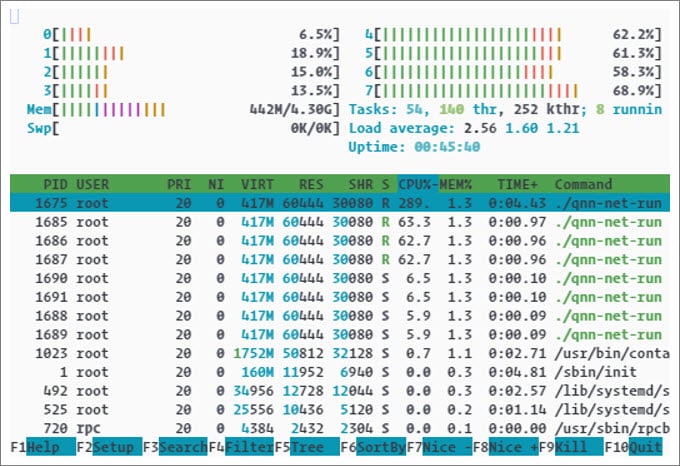
Trace Compass 中的 CPU 使用率
- 在主机上打开 Trace Compass 工具并加载跟踪。
- 右键单击跟踪,然后选择 Select Trace Type > Ftrace Format Type > Raw Textual Ftrace,如下图所示:
- 右键单击 Raw Textual Ftrace 并选择 Open。
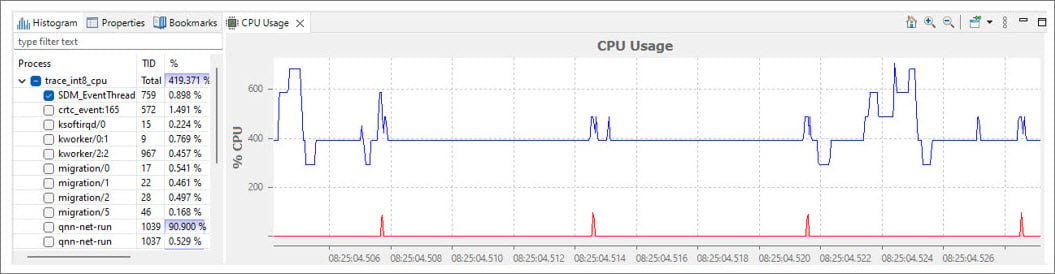
- 双击 CPU usage 查看系统级 CPU 使用率。在左侧面板中选择一个任务以检查每个任务的 CPU 使用率,如下图所示:
监控用户空间应用的内存消耗
您可以检查各种进程的内存分配和内存使用情况。 要检查某个进程的内存消耗,请在设备上运行以下命令: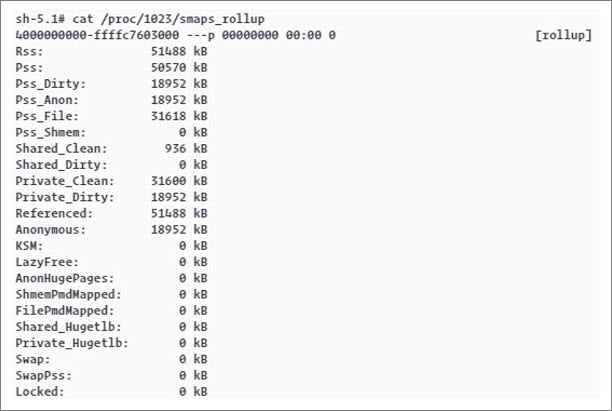
Procrank
Procrank 是一款显示每个进程内存消耗的工具。默认情况下,它显示以下集大小:- VSS:虚拟集大小(Virtual set size)
- RSS:常驻集大小(Resident set size)
- PSS:按比例集大小(Proportional set size)
- USS:独占集大小(Unique set size)
从源代码构建 Procrank
在主机上运行以下命令:- 启动设备。
- 登录串口 shell。
- 运行以下命令:
- 要启动 ADB,请使用以下选项之一:
- 选项 1:重启设备。
- 选项 2:运行以下命令:
/etc/usb-debugging-enabled 文件并重启设备,否则 ADB 将保持活跃状态。
使用 Android Debug Bridge(adb)或类似工具将 Procrank 文件从主机传输到设备。示例命令如下:
请确保在命令中指定目标 IP 地址。
- 要查看每个进程分配的匿名内存,请在设备上运行以下命令:
- 要显示每个进程分配的文件缓存内存,请在设备上运行以下命令:
- 要同时查看每个进程分配的匿名内存和文件缓存内存,请在设备上运行以下命令:
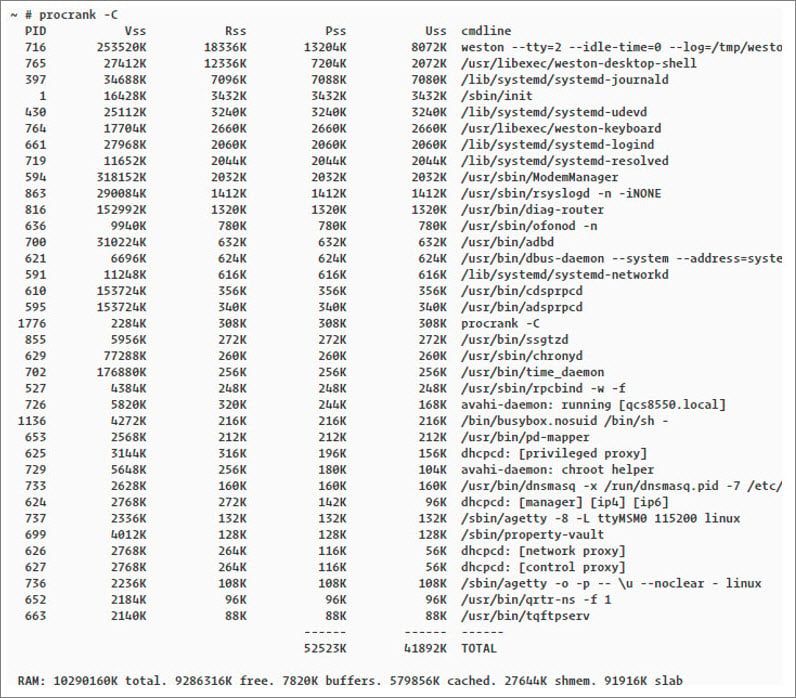
procrank -C 命令的示例输出:
检查应用的每周期指令数
perf 实用工具使用硬件性能计数器计算应用的每周期指令数(IPC)。 要编译 perf 实用工具,请参见编译性能工具。 要计算 IPC,请在设备上运行以下命令: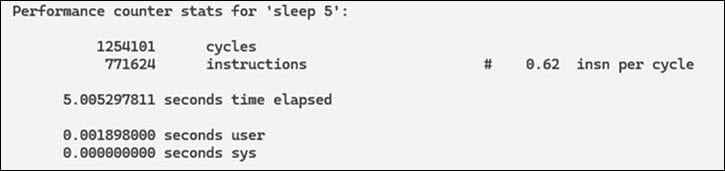
- 如果 IPC 小于 1.0,则很可能是内存受阻。在这种情况下,Qualcomm Linux 调优策略(例如减少内存 I/O 工作负载)有助于提升性能。
- 如果 IPC 大于 1.0,则很可能是指令受限。在这种情况下,通过消除不必要的工作和缓存操作来减少代码执行,有助于提升性能。
检查消耗 CPU 最多的代码部分
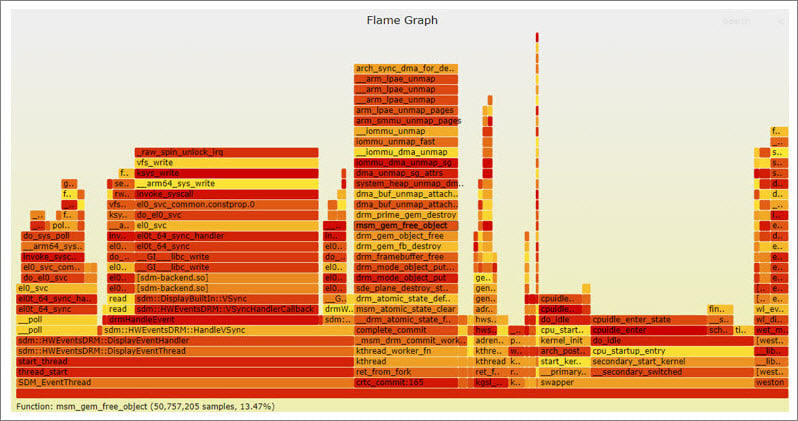
perf 实用工具可以生成火焰图(flame graph),帮助可视化线程的栈以及在 CPU 上运行的所有函数的 CPU 使用情况。 要生成火焰图,请执行以下操作:- 在设备上:
- 收集日志以生成火焰图。要使用 perf 实用工具收集日志,请运行以下命令:
- 使用 SCP 或类似工具运行以下命令,将
perf.script从目标设备传输到主机。请确保在命令中指定目标 IP 地址。示例命令如下:
- 收集日志以生成火焰图。要使用 perf 实用工具收集日志,请运行以下命令:
- 在主机上:
- 运行以下命令下载火焰图:
请确保在主机上安装 Perl。 - 将
perf.script复制到FlameGraph目录中: - 在浏览器中打开 SVG 文件查看火焰图,以了解 CPU 使用情况:
- 运行以下命令下载火焰图:
检查用户空间应用代码中各函数消耗的内存
Valgrind 是一款开源工具,提供了名为 massif 的实用工具,可帮助分析程序中每个函数消耗的内存。 以下是内存分配的示例代码:…
n3: 20000 (heap allocation functions) malloc/new/new[], —alloc-fns, etc.
n0: 10000 0x10882B: main (in /home/root/valgrind/test)
n2: 8000 0x1087E7: g (in /home/root/valgrind/test)
n1: 4000 0x108807: f (in /home/root/valgrind/test)
n0: 4000 0x10885B: main (in /home/root/valgrind/test)
n0: 4000 0x10885F: main (in /home/root/valgrind/test)
n1: 2000 0x108803: f (in /home/root/valgrind/test)
n0: 2000 0x10885B: main (in /home/root/valgrind/test) 有关 Valgrind 的更多信息,请参见 Valgrind User Manual。
检测用户空间应用中的内存泄漏
要检测进程内的内存泄漏,可以使用启用了 leak-check 功能的 Valgrind 工具。 以下是已分配但未释放内存的示例代码:高级排查
高级排查方法用于系统层面。这些方法对于构建 Qualcomm 参考设备以及在所有层面集成 Qualcomm Linux 以生产最终产品至关重要。 有关相关信息,请参见基本排查。启动时间
启动时间的各阶段和启动时间日志标记有助于调试和优化启动过程。 Qualcomm Linux 启动链可分为两个阶段:- 引导加载程序初始化和内核加载:启动引导加载程序并加载内核。
- Linux 系统初始化:初始化内核、驱动和用户空间服务。
第一阶段时间线(引导加载程序初始化和内核加载)
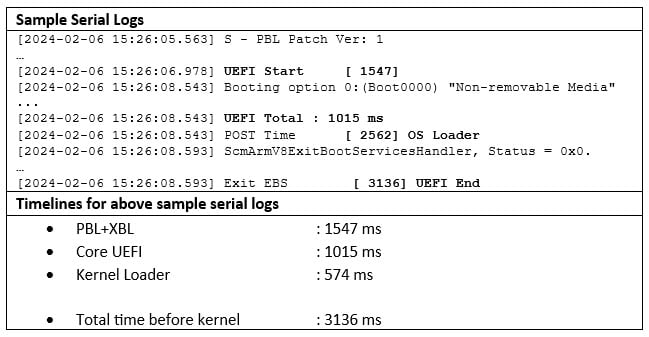
在设备启动序列期间,收集串口日志。解析这些日志可以更好地了解该阶段的里程碑。 可以使用下表列出的相应时间戳来测量各模块所花费的时间:
有关如何收集串口日志的更多信息,请参见测量启动时间。
以下是示例串口日志和时间线的示例:
第二阶段时间线(Linux 系统初始化)
要捕获系统启动期间的性能统计信息,请使用 systemd-analyze 工具。 要安装该工具,请参见使用工具分析性能。 要分析内核中驱动的初始化情况,请在内核启动命令行中启用initcall_debug 标志。使用 systemd-analyze 工具分析用户空间服务和应用的初始化详情。
以下是您可以在设备上运行以使用 systemd-analyze 工具的示例命令:
- 要获取内核和用户空间的启动时间,请运行以下命令:
以下是该命令的输出:Linux QCS6490 (Linux 6.6.0 #1 SMP PREEMPT Sun Feb 4 18:35:47 UTC 2024) arm64. Startup finished in 4.238s (kernel) + 15.620s (userspace) = 19.859s multi-user.target reached after 15.594s in userspace
- 要获取启动期间每个子系统消耗的时间,请运行以下命令:
以下是该命令的输出:4.982s android-tools-adbd.service
3.013s dev-disk-byx2dpartlabel-system.device
1.418s systemd-modules-load.service
1.179s sshdgenkeys.service
系统初始化时间的图形视图
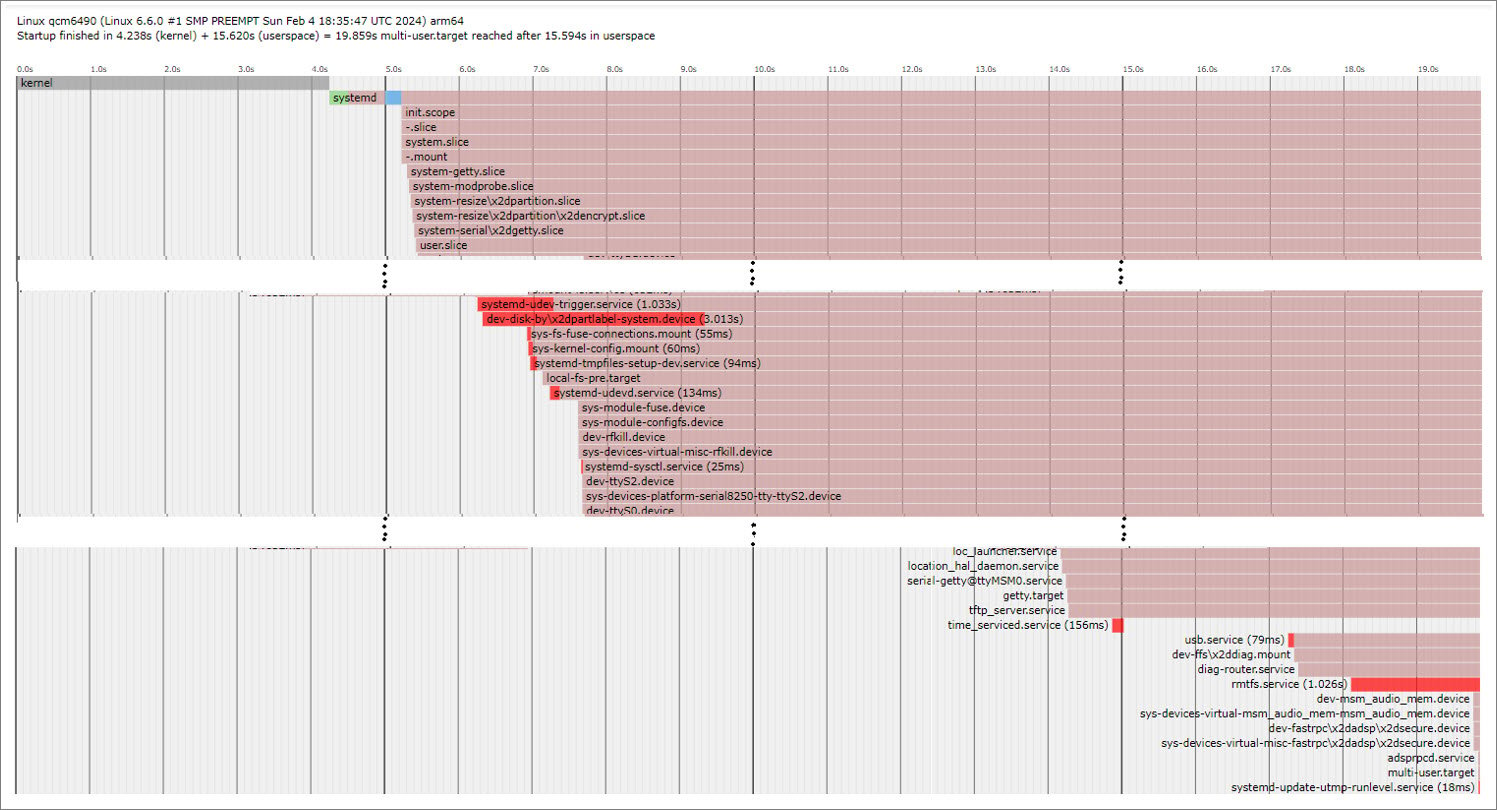
systemd-analyze plot 命令提供已启动的系统服务及其初始化时间的图形化明细。
要获取系统服务的图形化明细,请在设备上运行以下命令:
systemd-plot.svg 文件。下图显示了示例图表:
识别 CPU 受限的用例
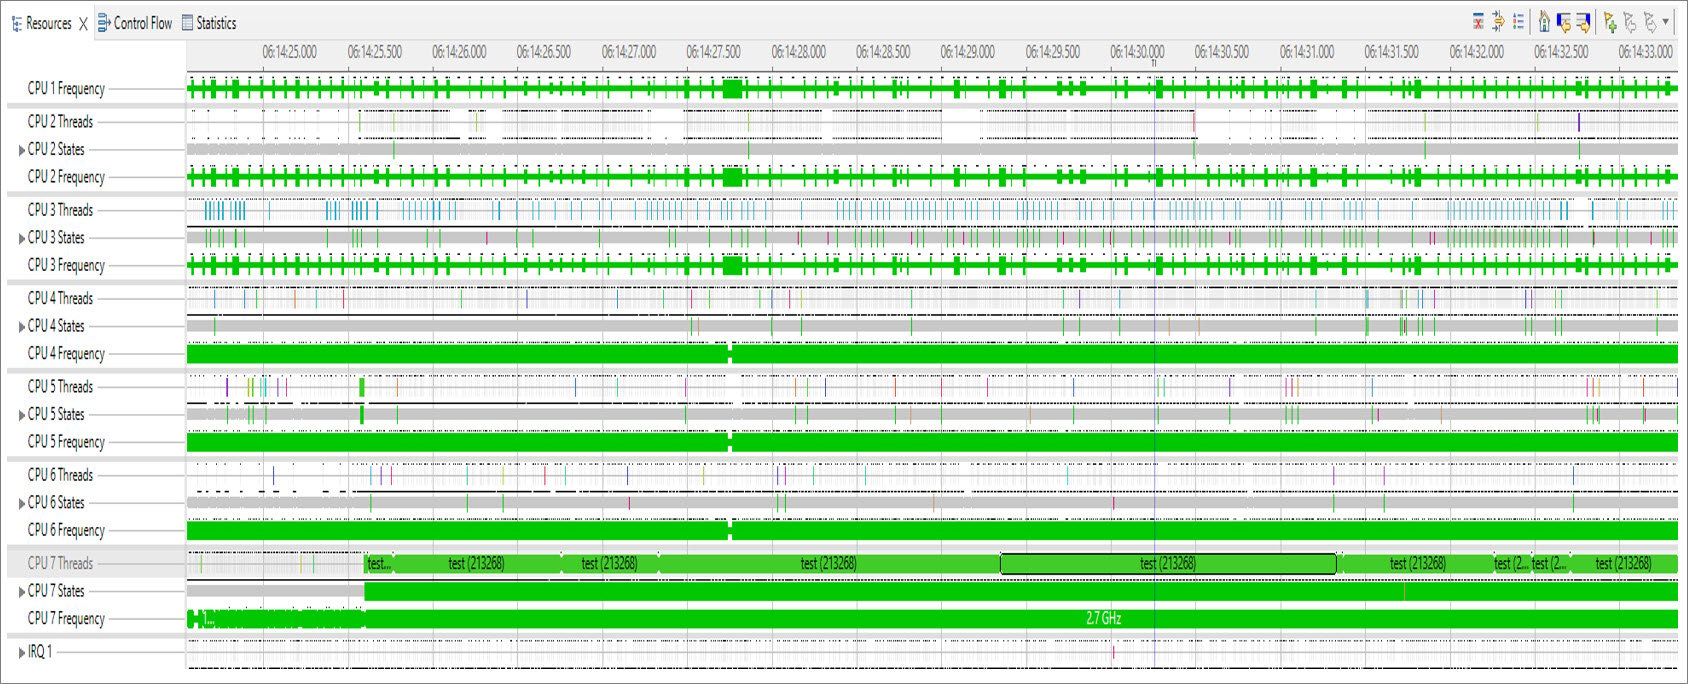
要验证任务是否在能力最强的 CPU 上以最大频率运行,请捕获调度器和频率 ftrace。 以下是使用while 循环加载 CPU 的示例代码:
识别 I/O 受限的用例
要获取 I/O 统计信息,请使用/proc/diskstats。
更多信息请参见 /proc/diskstats。
以下是在设备上针对 I/O 受限用例运行 lmdd 的示例:
- 在运行用例之前,运行以下命令:
以下是该命令的输出:8 10 sda10 715 544 15056 250 4394 413 4199944 135729 0 5508 135979 0 0 0 0 0 0 接下来,从 vmstat 获取
pgpgin和pgpgout:以下是该命令的输出:pgpgin 348632pgpgout 2100056 - 要运行 lmdd,必须先编译 lmbench,更多信息请参见编译性能工具。对于 I/O 受限的用例,运行以下 lmdd 命令:
- 运行用例后,运行以下命令:
以下是该命令的输出:8 10 sda10 4822 544 4209448 13018 8530 451 8394624 300094 0 11836 313112 0 0 0 0 0 0
- 接下来,再次检查
pgpgin和pgpgout:以下是该命令的输出:pgpgin 2446172pgpgout 4197396
Vmstat
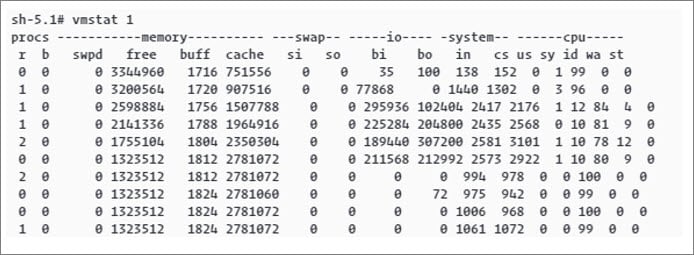
Vmstat 是一个 Linux 命令,用于收集块输入(bi)和块输出(bo)的信息。下图显示了 vmstat 输出的示例:
对重负载用例使用大核心
当重负载任务以较长运行时间在 Silver 核心上运行时,可能会影响性能。使用sched_setaffinity() 将此类任务亲和到较大的(Gold)核心。这种任务亲和有助于减少 CPU 运行时间并提升性能。
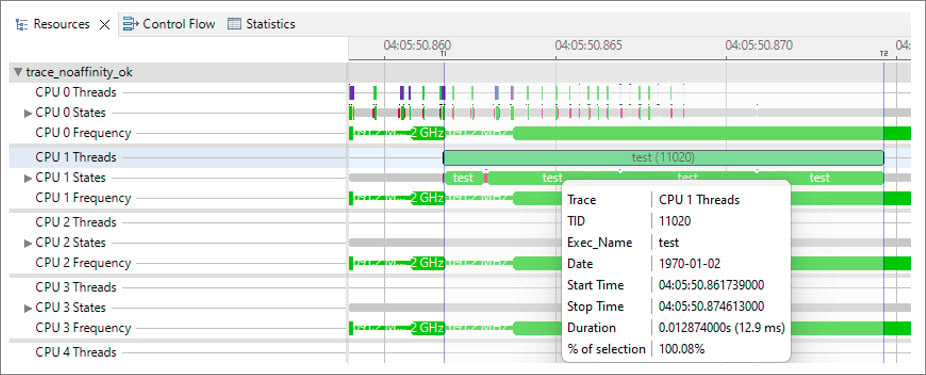
下图来自 Trace Compass,显示了一个测试线程在 CPU0 上以 1.9 GHz 的频率运行 12.9 毫秒的示例。
sched_setaffinity() 将任务亲和性设置到 Gold 核心,请参见 sched_setaffinity(2) — Linux manual page。
以下是将任务亲和到 Gold 核心 7 的示例代码:
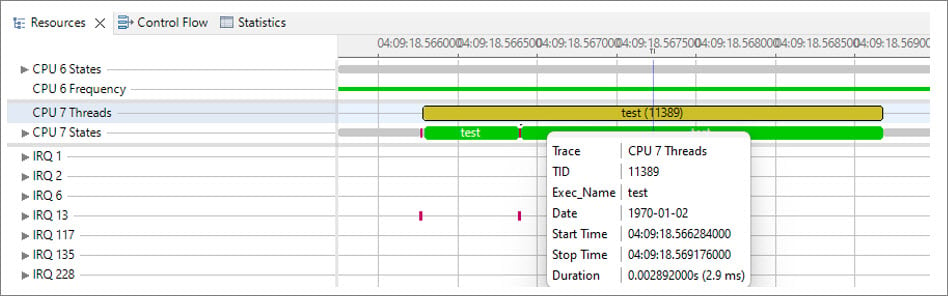
sched_setaffinity() 设置任务亲和性后,该任务在 CPU7 上运行,运行时间从 12.9 毫秒减少到 2.9 毫秒,CPU 频率为 2.7 GHz。
下图显示了设置 sched_setaffinity() 属性后减少的时间:
减轻可运行状态(runnable)对用例的影响
当任务已准备好运行但 CPU 不可用时,该任务被视为处于可运行(runnable)状态。当 CPU 负载较重时,任务会被赋予此状态。 要可视化线程的状态,可以使用 Trace Compass 的 Control Flow 视图。 下图以不同颜色显示线程状态:- 深红色线表示线程处于可运行状态
- 黄色线表示休眠状态
- 红色线表示 CPU 正忙于处理
irq或softirq
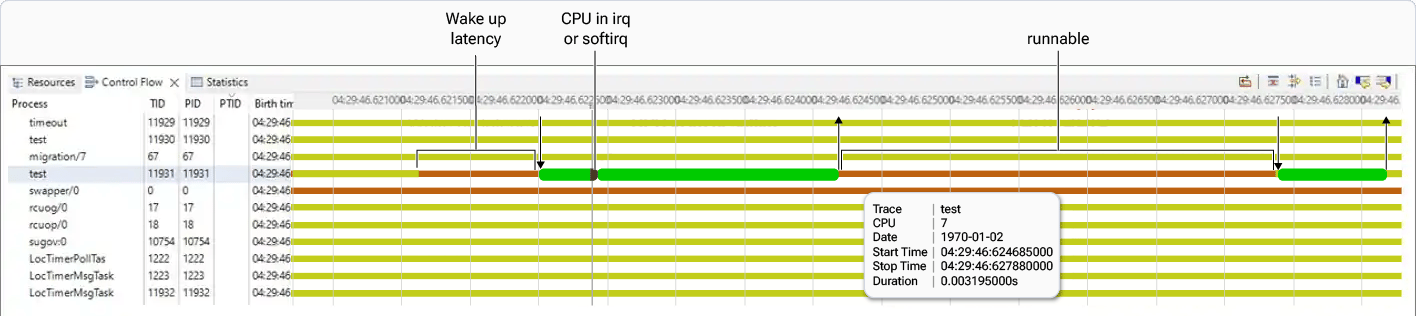
- 唤醒延迟型可运行是指已就绪的任务从可运行状态到实际在 CPU 上运行所需的时间。可以通过调优调度器或禁用 CPU 的低功耗模式来减少此延迟。
- 普通可运行发生在 CPU 选择更高优先级的进程运行而非当前进程时。提高任务的优先级有助于减少可运行状态。
- 实时(RT)线程的优先级范围为 0 到 99,数字越大表示优先级越高。要更改实时线程优先级,请在
sched_setscheduler()中使用SCHED_FIFO策略。 - 普通线程的优先级范围为 100 到 139,数字越小表示优先级越高。要更改普通线程优先级,请使用
reniceLinux 命令以及带SCHED_OTHER策略的sched_setscheduler()。–20 到 +19 范围内的值映射到 100 到 139 范围内的线程优先级。
sched_setscheduler()。
有关 sched_setscheduler(),请参见 sched_setscheduler(2)—Linux manual page。
以下是通过使用 sched_setscheduler() 更改线程优先级来减少可运行时间的示例代码:
SCHED_FIFO 用于 RT 线程。sched_priority 等于 1。
加速 CPU 频率爬升时间
延迟切换到所需的更高 CPU 频率会影响性能。您可以调优sched_util_clamp_min 调度器节点以加速 CPU 频率爬升。
在 0 到 1024 的范围内调优 sched_util_clamp_min。较高的值可以提升性能,但也可能增加功耗。
以下是测试线程在核心 4 上运行表现的示例:
- 当
sched_util_clamp_min为 0 时,CPU 频率从 691 MHz 缓慢爬升到 1.5 GHz,然后再到 1.7 GHz。您可以在设备上运行以下命令来设置此值:下图来自 Trace Compass,显示了 CPU 频率的爬升:
- 当
sched_util_clamp_min为 512 时,CPU 频率从 691 MHz 直接爬升到 1.9 GHz。您可以在设备上运行以下命令来设置此值:下图显示了 CPU 频率爬升到 1.9 GHz:
- 当
sched_util_clamp_min为 1024 时,CPU 频率从 691 MHz 直接爬升到 2.4 GHz 的最大频率(FMAX)。您可以在设备上运行以下命令来设置此值:下图显示了 CPU 频率从 691 MHz 直接爬升到 FMAX 2.4 GHz: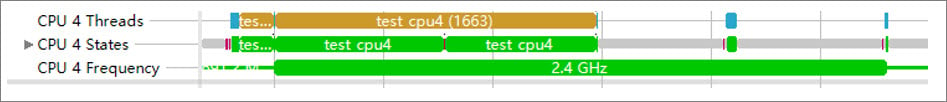
确定用例的缓存驻留情况
perf 实用工具用于分析缓存未命中和缓存重填计数器统计信息。此分析有助于确定用例在特定缓存中的驻留情况,例如 L2、L3 和末级缓存控制器(LLCC)DDR 驻留。 有关如何编译 perf 实用工具的说明,请参见编译性能工具。 要检查目标可用的缓存事件,请在设备上运行以下命令:识别锁争用
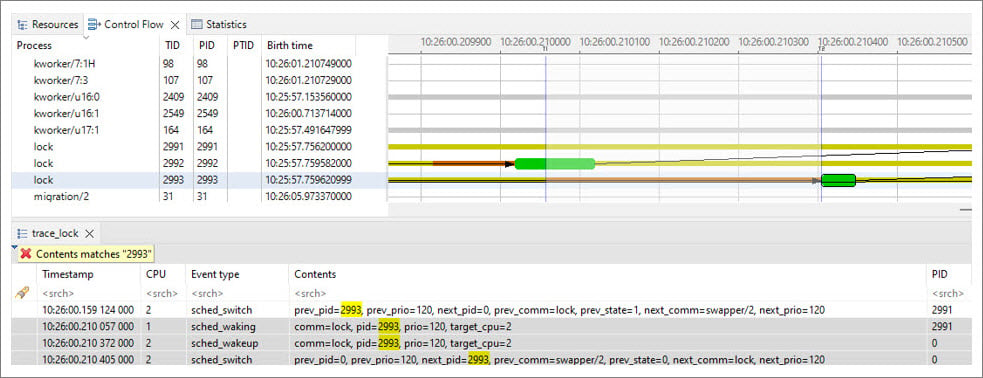
当一个线程(thread_1)尝试获取已被另一个线程(thread_2)持有的互斥锁(Mutex)时,就会发生锁争用。 在这种情况下,thread_1 进入休眠模式,并在 thread_2 释放互斥锁时被唤醒。 要解决此问题,请转到 Trace Compass 并选择 Select Previous State Change,如下图所示:
确定抢占禁用的持续时间
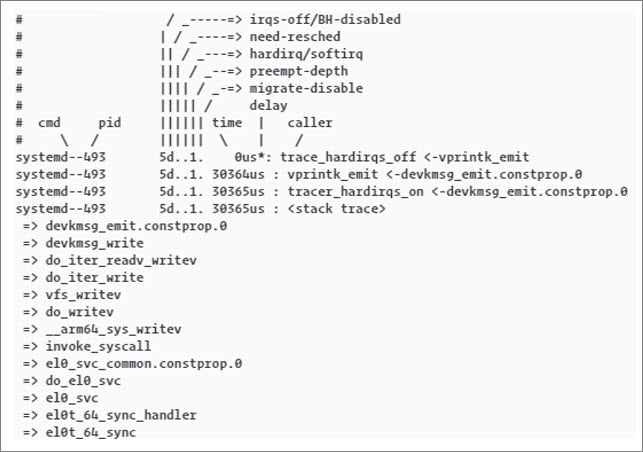
内核以抢占方式运行。这意味着任何内核进程都可能随时被暂停,以让位于更高优先级的进程。因此,新任务可以在先前任务被抢占的同一临界区中开始运行。 以下步骤概述了如何记录抢占被禁用的持续时间:- 在内核配置中,在源代码中启用
CONFIG_IRQSOFF_TRACER和CONFIG_PREEMPT_TRACER。 - 要收集跟踪,请运行以下命令:注意 以下命令应在设备上运行。
调试丢帧
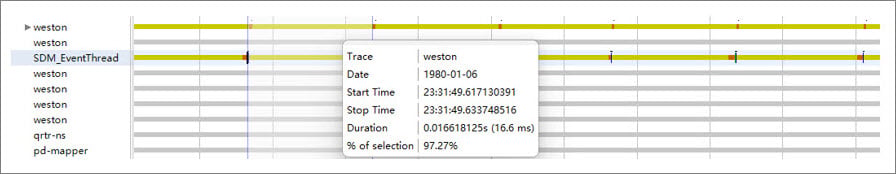
丢帧可能是由于各种子系统(如显示或摄像头)的延迟造成的。例如,如果显示刷新率为 60 Hz,则每帧必须在 16.6 毫秒内完成。 下图显示了一个跟踪,其中Weston 和 SDM_EventThread 每 16.6 毫秒运行一次。任何应用都必须周期性地渲染,并在这 16.6 毫秒的时间窗口内完成渲染。如果在此窗口到期前渲染未完成,则会丢帧。
识别内存颠簸(memory thrashing)
当系统花费大量时间从 RAM 中回收内存,然后又将相同内容重新加载回 RAM 时,就会发生内存颠簸。 这可能发生在来自磁盘的文件缓存页和来自 ZRAM 的匿名页上,导致性能大幅下降。 内存颠簸通常发生在可用内存不足以满足当前用例(称为工作集,workingset)时。这会导致系统难以找到可回收的内存。 您可以通过/proc/vmstat 中的以下信息识别内存颠簸:
要识别内存颠簸,请在设备上运行以下命令: