选择后端
- CPU:无需特殊驱动或额外的构建标志。可作为与 GPU 或 NPU 性能对比的基准。
- GPU(OpenCL):使用 OpenCL 后端构建 llama.cpp,将模型层卸载到 Adreno GPU。同一构建也可以通过跳过 GPU 卸载在 CPU 上运行。
- NPU(Hexagon HTP):使用 Snapdragon 工具链容器构建 llama.cpp,将模型层卸载到 Hexagon HTP 设备(
HTP0),在受支持的模型上获得最佳性能。
- NPU(Hexagon HTP)
- GPU(OpenCL)
- CPU
概述
使用 Hexagon HTP 后端为 Dragonwing 设备构建 llama.cpp,然后在HTP0 上运行 GGUF 大语言模型。这些说明侧重于将 Hexagon HTP 设备公开为
HTP0 的 Snapdragon 和 Dragonwing llama.cpp 构建。这与 GPU 选项卡中的 OpenCL GPU 工作流不同。前提条件
在开始之前,请确保您已:- 完成 Dragonwing 设备的首次设置:
- 可以通过 SSH 或直接连接的显示器、键盘和鼠标访问设备。
- 上面链接的设置指南包含网络、串行控制台访问、显示设置和 SSH 访问的说明。
- 在设备上安装了所需的 Dragonwing 软件包:
- 在构建主机上安装了 Docker。
- 有足够的可用空间用于构建输出和模型。每个模型请预留数 GB 空间。
libqnn-dev 和 qnn-tools。准备构建主机
在构建主机上,克隆 llama.cpp 或更新现有的检出。使用 Snapdragon 工具链容器构建 llama.cpp
为 Dragonwing 构建 llama.cpp 最简单的方法是使用 Snapdragon ARM64 Linux 工具链容器。该容器包含 Snapdragon 预设所需的 ARM64 交叉编译器、CMake、OpenCL SDK 和 Hexagon SDK 组件。下面的 Docker 命令显式请求linux/amd64 镜像。从 llama.cpp 检出目录的根目录启动容器:当上游 llama.cpp 变更时重新构建
llama.cpp 变更频繁。要使用最新的上游代码重新构建,请从主机检出目录重复以下更新和构建流程:如果您要测试某个分支、标签或本地 llama.cpp 改动,请在运行 Docker 构建命令之前先检出该源码。
将软件包复制到 Dragonwing 设备
请将ubuntu@DEVICE_IP 替换为您的 SSH 用户和目标 IP 地址。将其设为设备上的默认 llama.cpp 安装
打包的二进制文件需要LD_LIBRARY_PATH 和 ADSP_LIBRARY_PATH 才能找到打包的 llama.cpp 和 Hexagon 后端库。将其设为默认安装的最安全方法是把软件包移动到 /opt 并在 /usr/local/bin 中创建包装命令。在 Dragonwing 设备上运行以下命令:llama-cli 和 llama-server 创建包装命令:下载模型
llama.cpp 使用 GGUF 格式的模型。一个小型的 instruct 模型很适合作为首次测试。在 Dragonwing 设备上创建模型目录:模型的支持情况和性能因架构、量化方式、上下文长度和 llama.cpp 提交而异。如果您发现某个模型或量化方式在 Dragonwing 设备上运行得特别好,请与社区分享。
在 HTP0 上运行您的第一个提示词
运行llama-cli 并将模型层卸载到 Hexagon HTP 设备:--device HTP0选择 Hexagon HTP 后端。-ngl 99要求 llama.cpp 将模型层卸载到所选设备。-m指向您的 GGUF 模型文件。-p传入用于单次提示词测试的提示词。
启动 llama-server
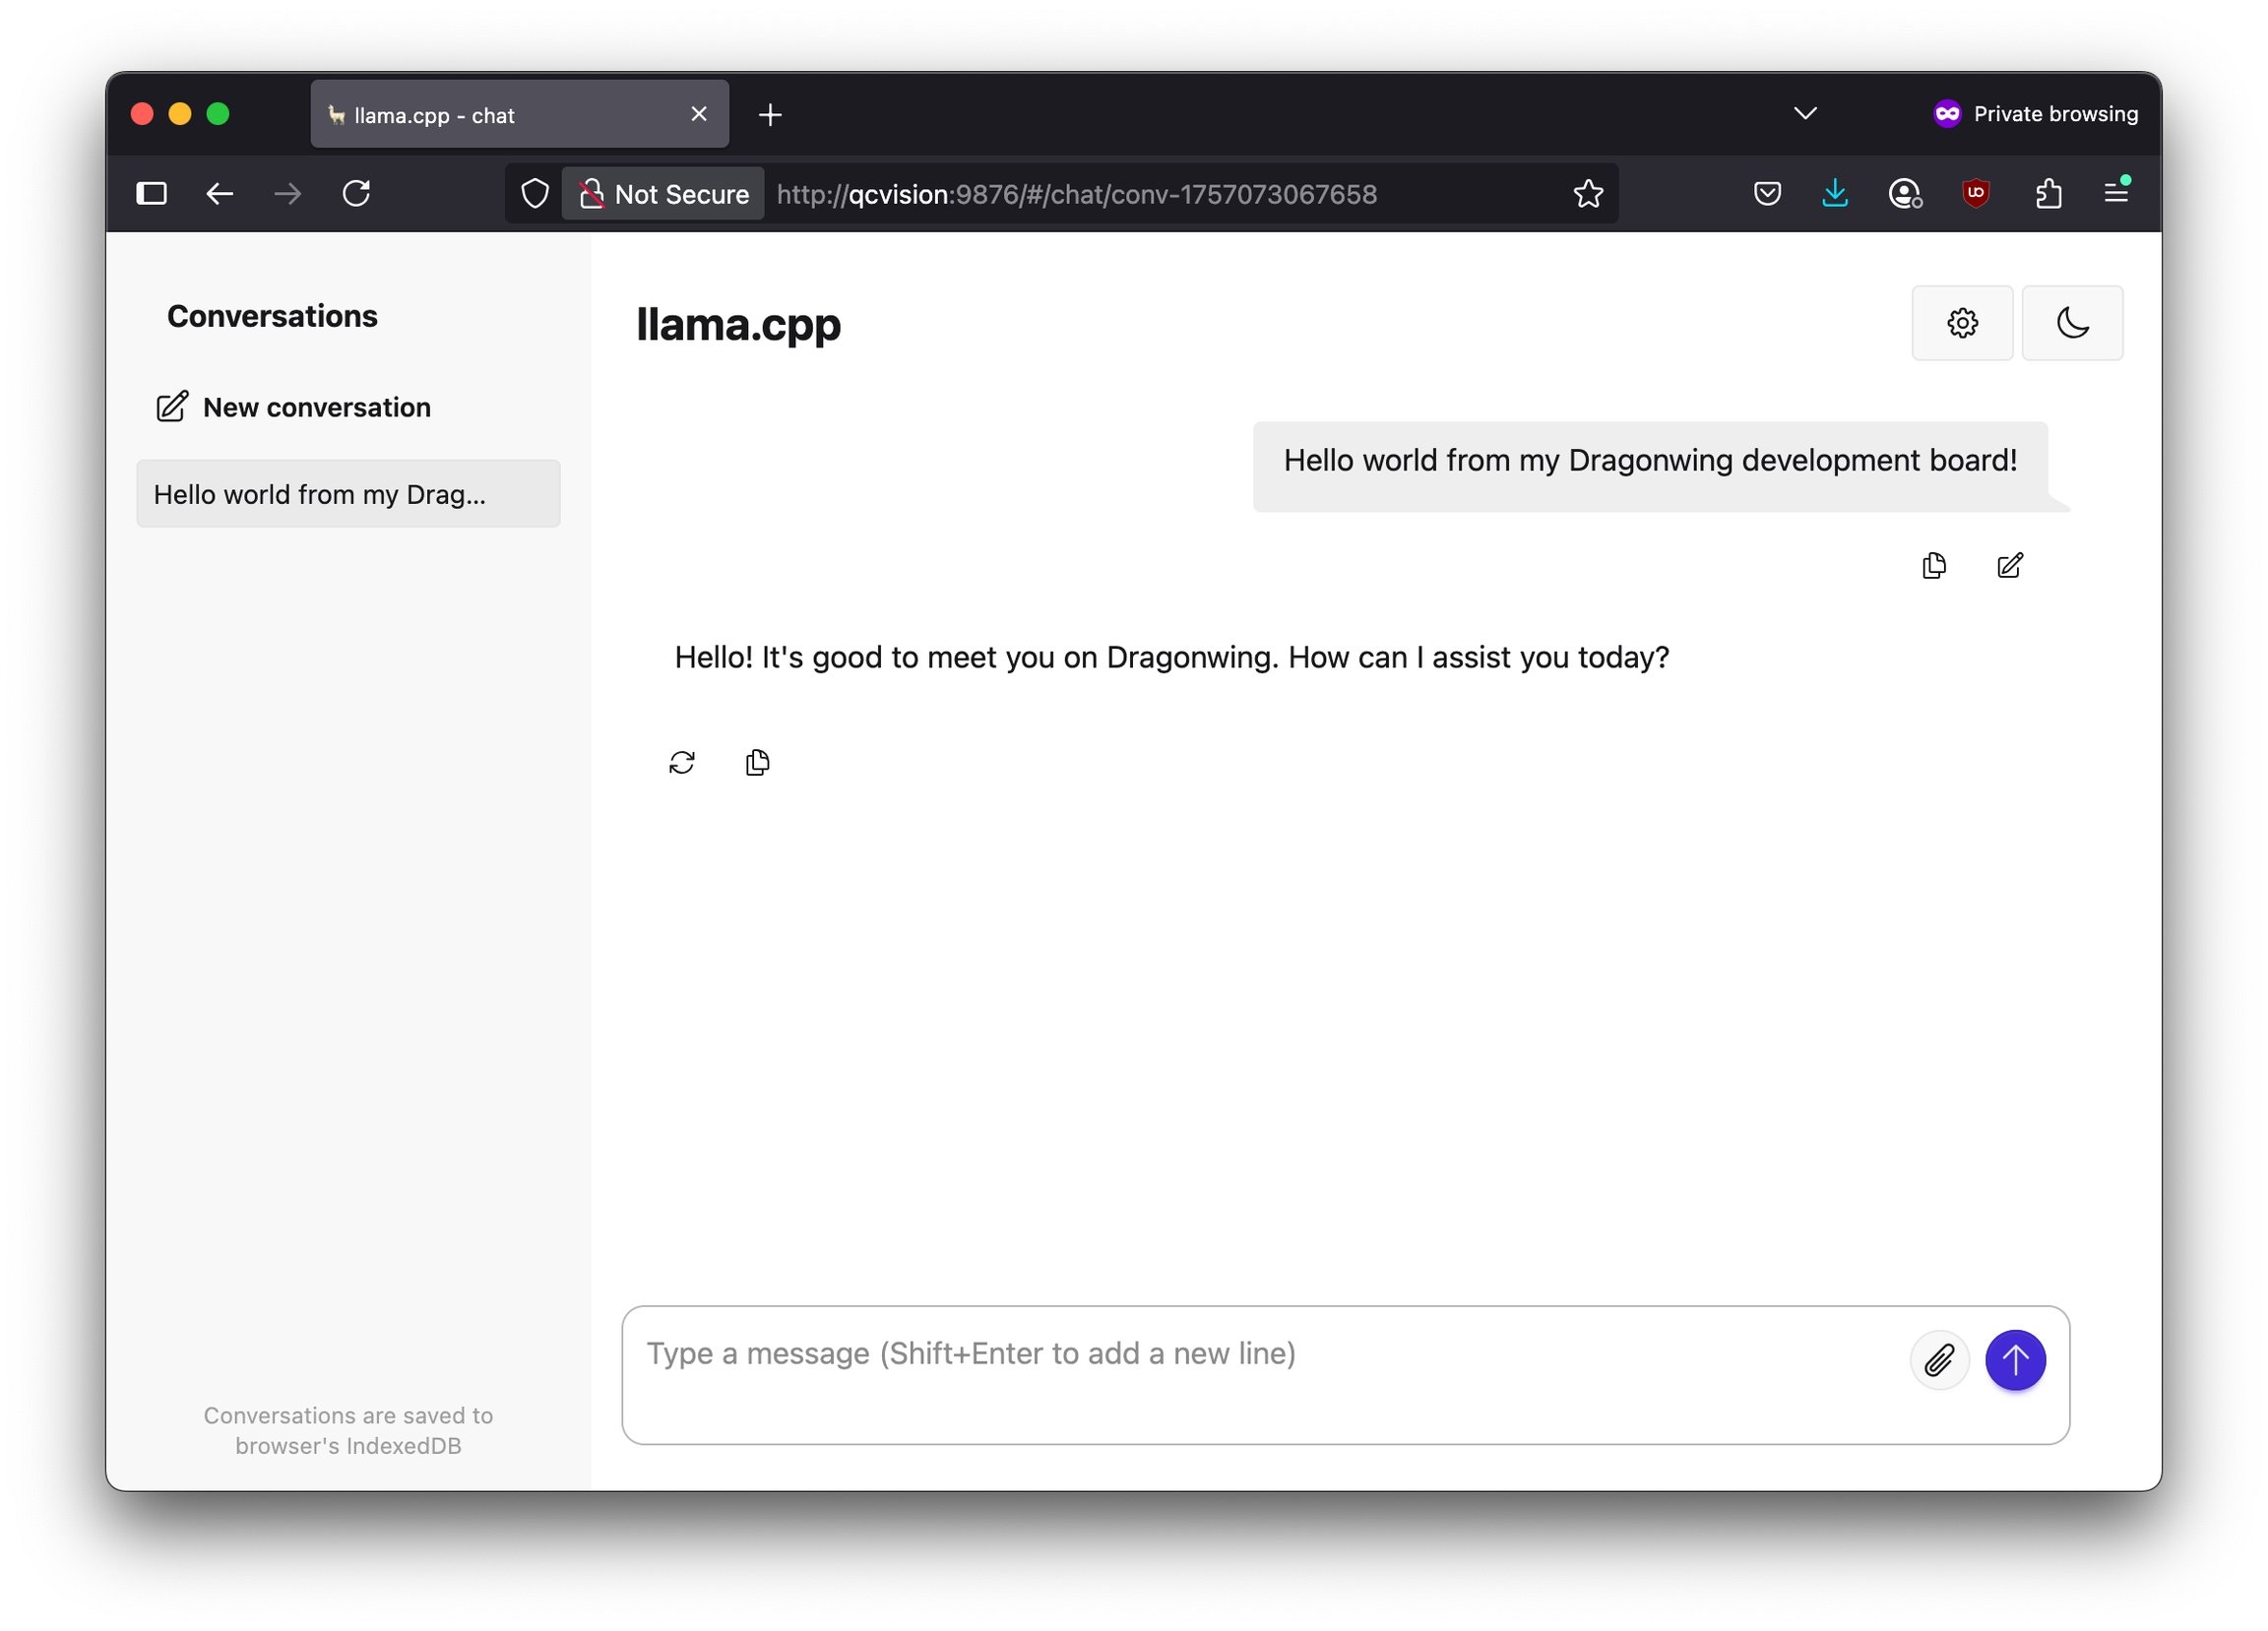
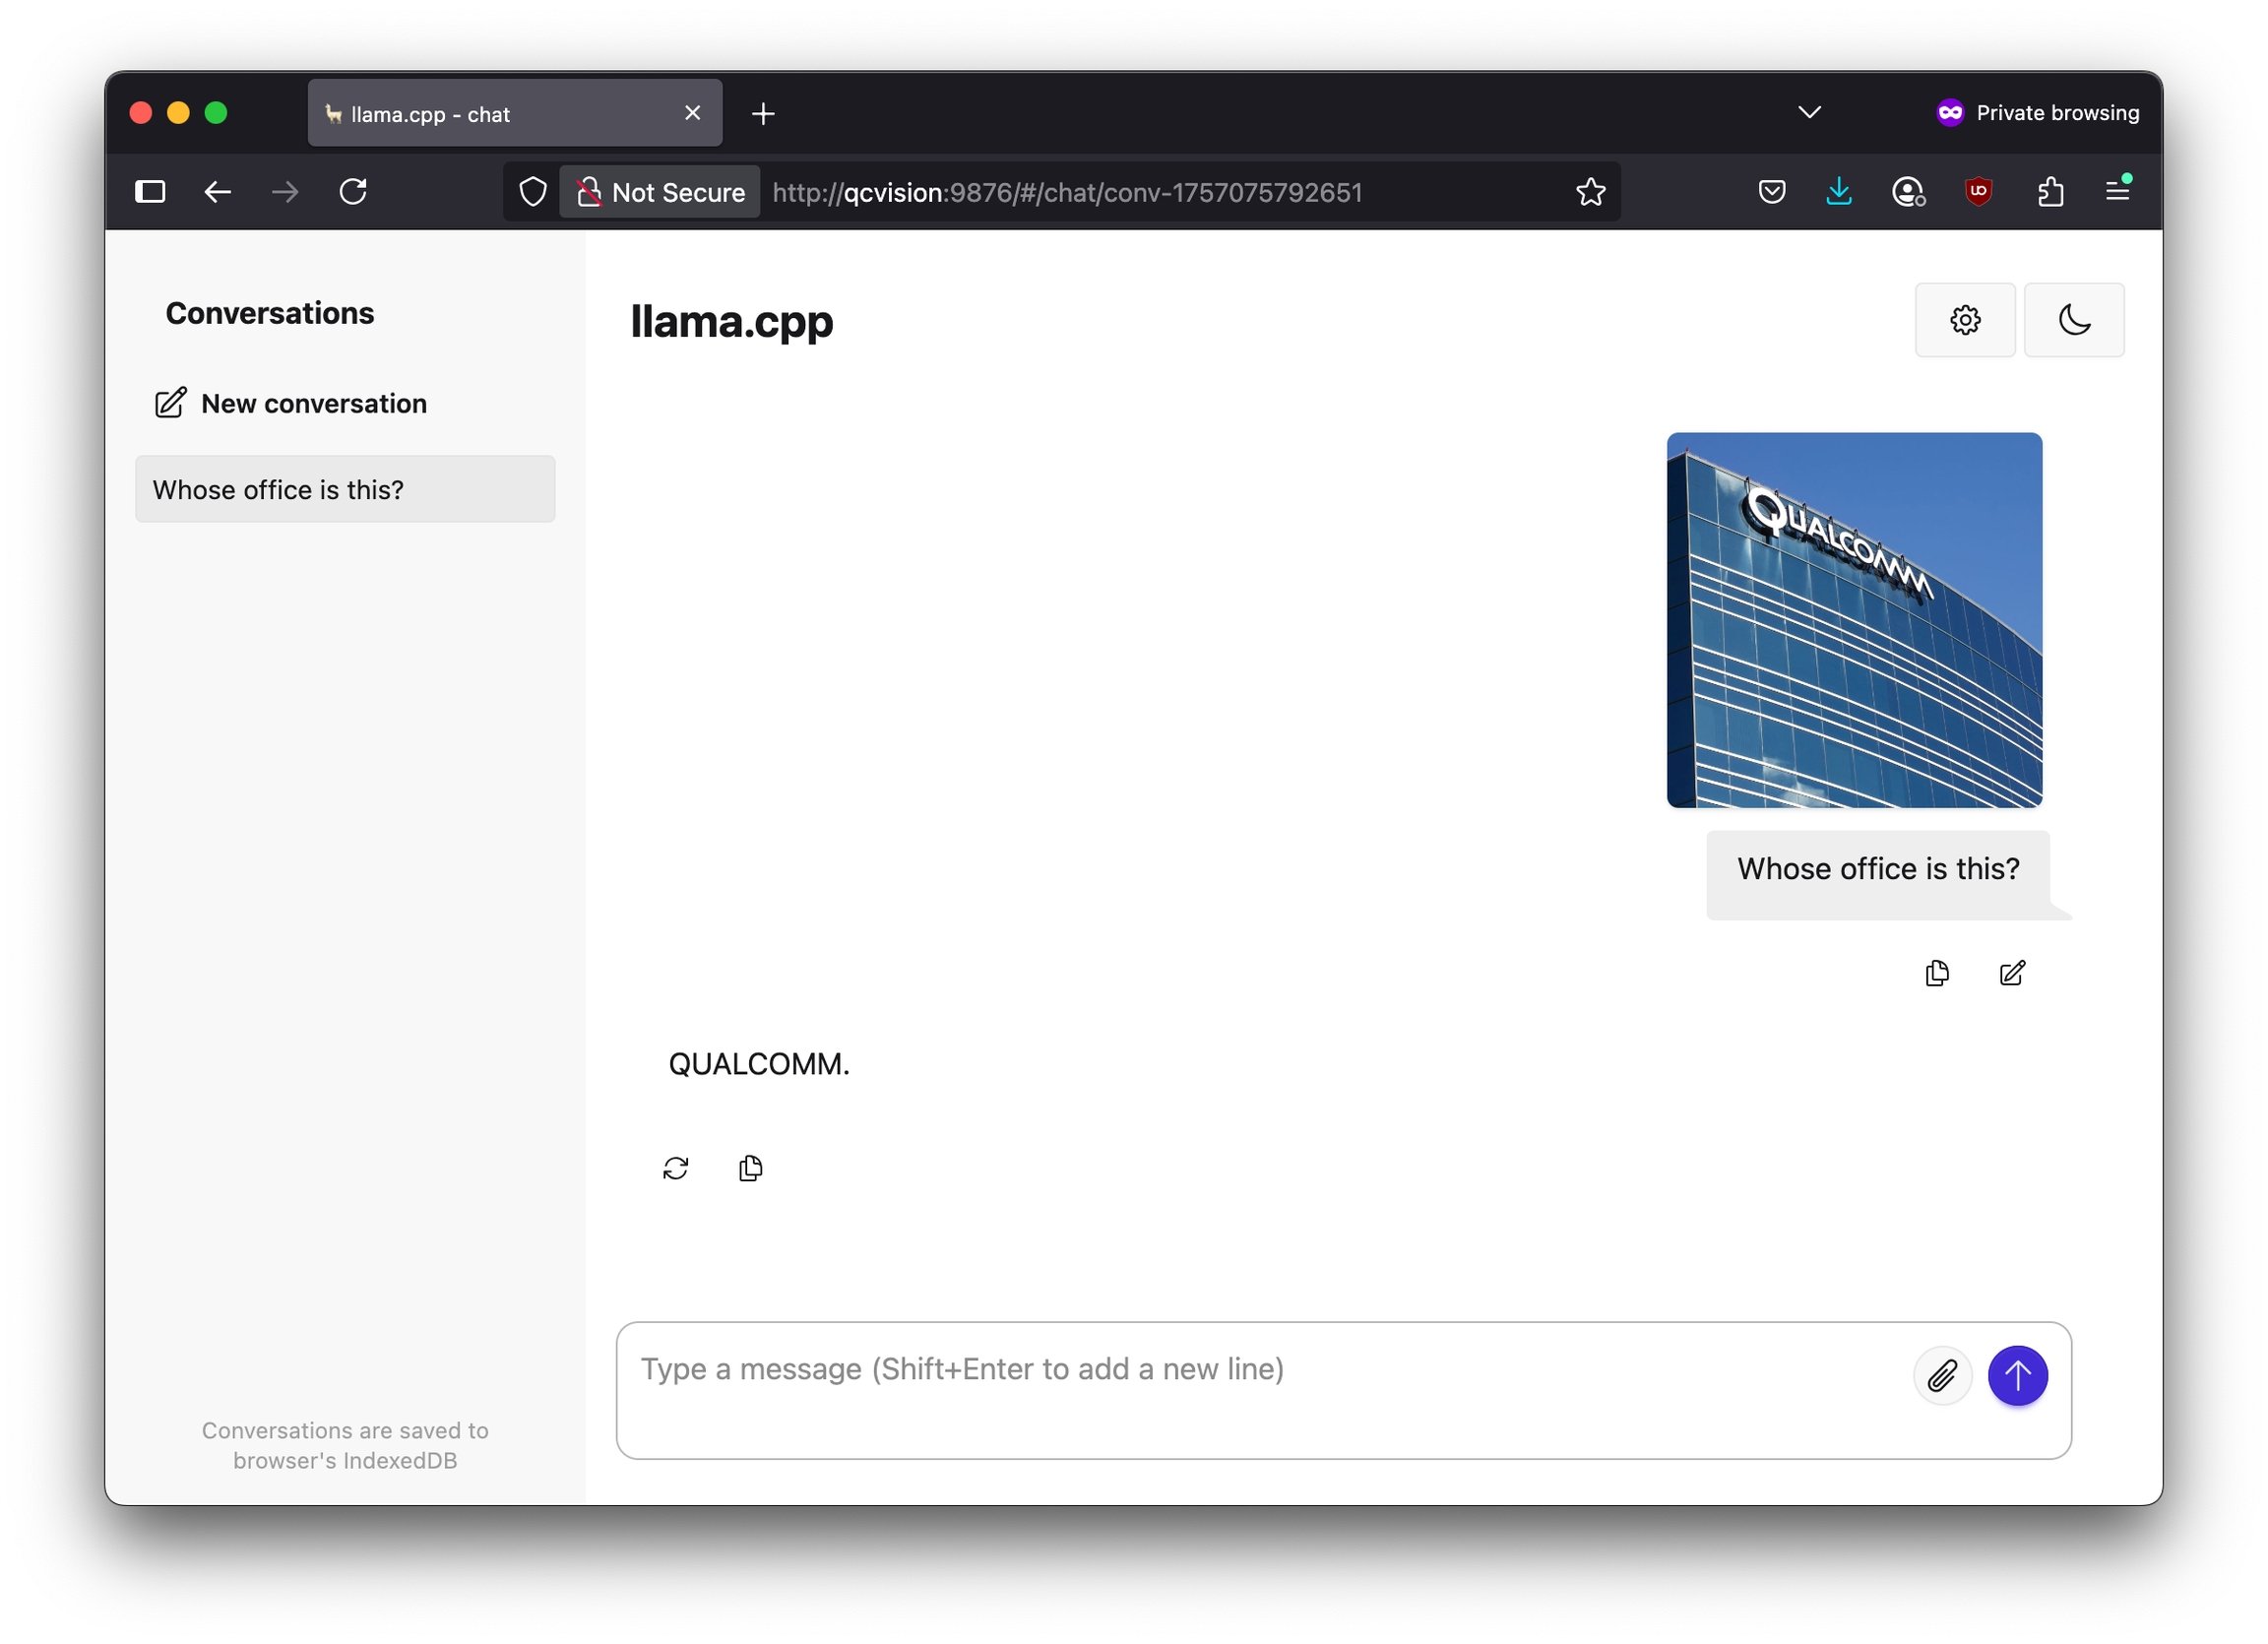
llama-server 提供一个本地 Web UI 和一个兼容 OpenAI 的 API。在 Dragonwing 设备上启动服务器:curl 测试 API:重新构建后更新默认安装
在重新构建并将新的pkg-snapdragon.zip 复制到设备后,更新 /opt/llama.cpp-snapdragon:/usr/local/bin 中的包装命令。故障排除
error while loading shared libraries如果直接从软件包目录运行二进制文件,请先设置库路径:/usr/local/bin/llama-cli。HTP0 未出现确认已安装所需的 Dragonwing 软件包,尤其是 libqnn-dev 和 qnn-tools。然后再次检查设备:/usr/local/bin 之前,请更新您的 PATH,或显式调用 /usr/local/bin/llama-cli。