

benchmark_model 工具,用于测量模型通过 delegate 在硬件上执行的性能。此工具与其他 LiteRT 构件一起安装在目标设备上。
该工具测量并报告以下性能指标:
- 初始化时间
- 推理时间(预热和稳定状态)
- 初始化期间的内存使用量
- 总体内存使用量
前提条件
在运行基准测试之前,请确保具备以下条件:- 一台 Ubuntu 22.04 主机
- 一套 Qualcomm 开发套件
设置模型文件
- 下载示例模型、标签文件和一张测试图片:
-
在主机上,下载并解压 MobileNet 模型归档文件:
-
在目标设备上,创建构件目录:
-
在主机上,将模型、图片和标签文件复制到设备:
-
在目标设备上,设置 GPU 库:
在 CPU 上进行基准测试
label_image 示例应用程序已使用 LiteRT 库交叉编译并安装在目标设备上。源代码可在 TensorFlow GitHub 仓库中获取。
要在 CPU 上使用 XNNPACK delegate 进行基准测试:
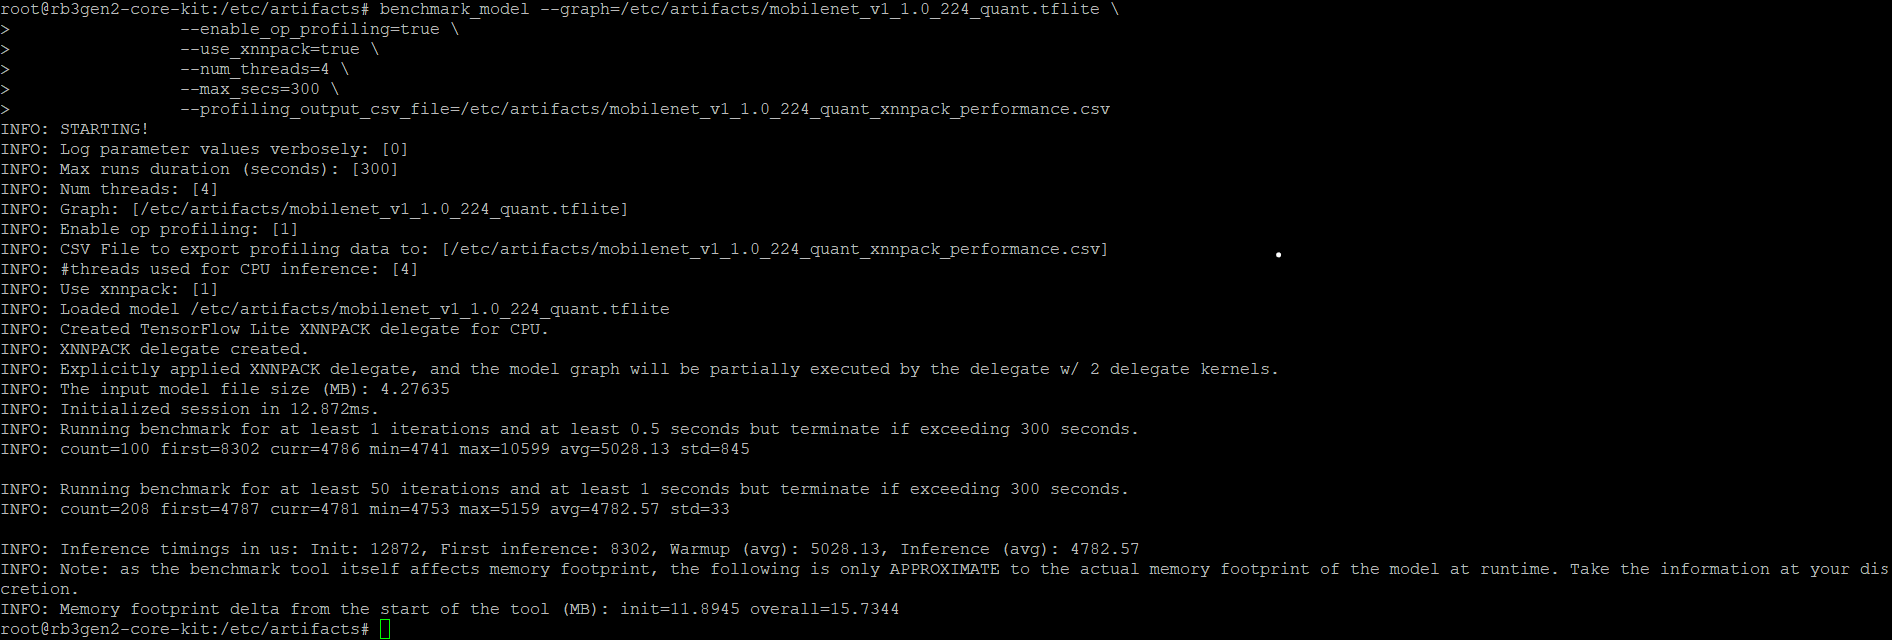
LiteRT CPU 基准测试示例输出
在 GPU 上进行基准测试
要使用 GPU delegate 进行基准测试: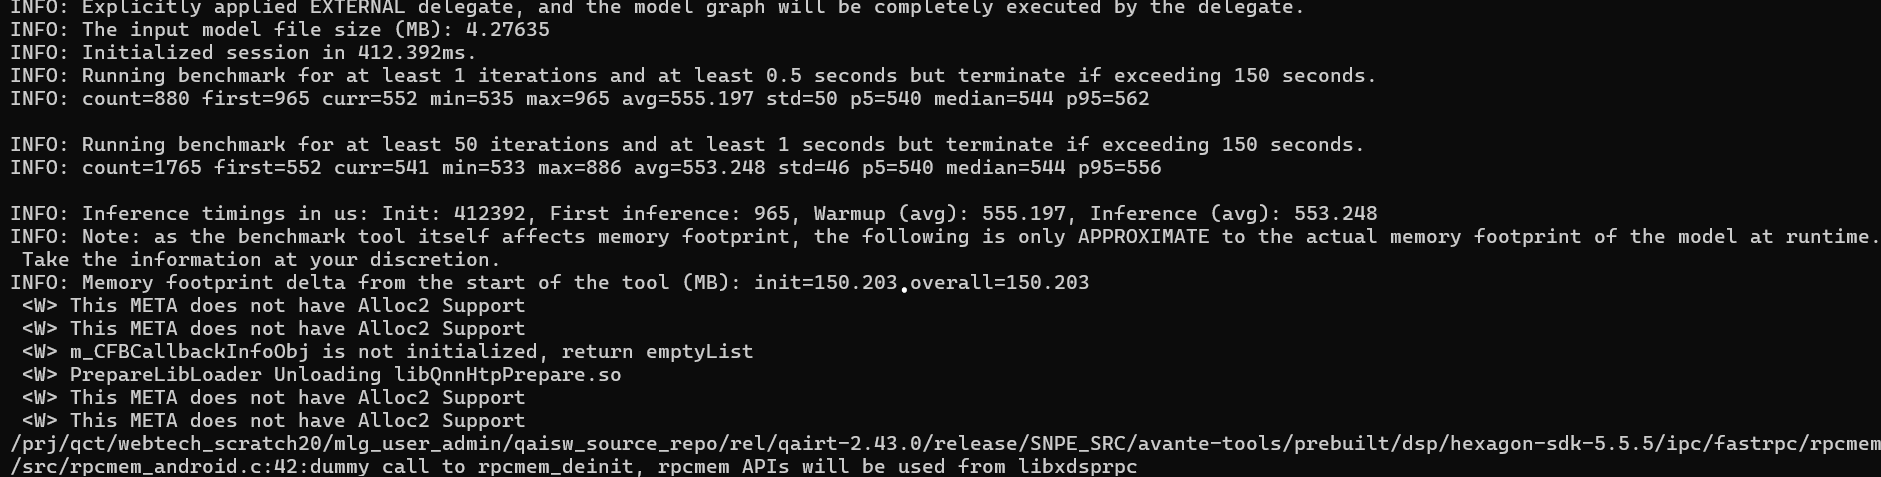
LiteRT GPU 基准测试示例输出
使用 QAIRT delegate 在 NPU 上进行基准测试
Qualcomm AI Runtime delegate 使用 Qualcomm AI Runtime API 及其后端在 Adreno GPU 和 Hexagon Tensor Processor 上加速模型。 要使用 QAIRT 外部 delegate,请确保设备上具有以下库:libQnnTFLiteDelegate.so—— QNN delegate 库- 来自 Qualcomm AI Engine Direct SDK 的库
libQnnGpu.so—— 在 GPU 上运行 QNN delegatelibQnnHtp.so—— 在 Hexagon Tensor Processor 上运行 QNN delegatelibQnnDsp.so—— 在 DSP 上运行 QNN delegate
- QCS6490/QCS5430、IQ-9075 和 QCS8275
- IQ-615
- Delegate 创建状态
- 使用该 delegate 在硬件上的平均推理时间
- 模型执行的内存占用
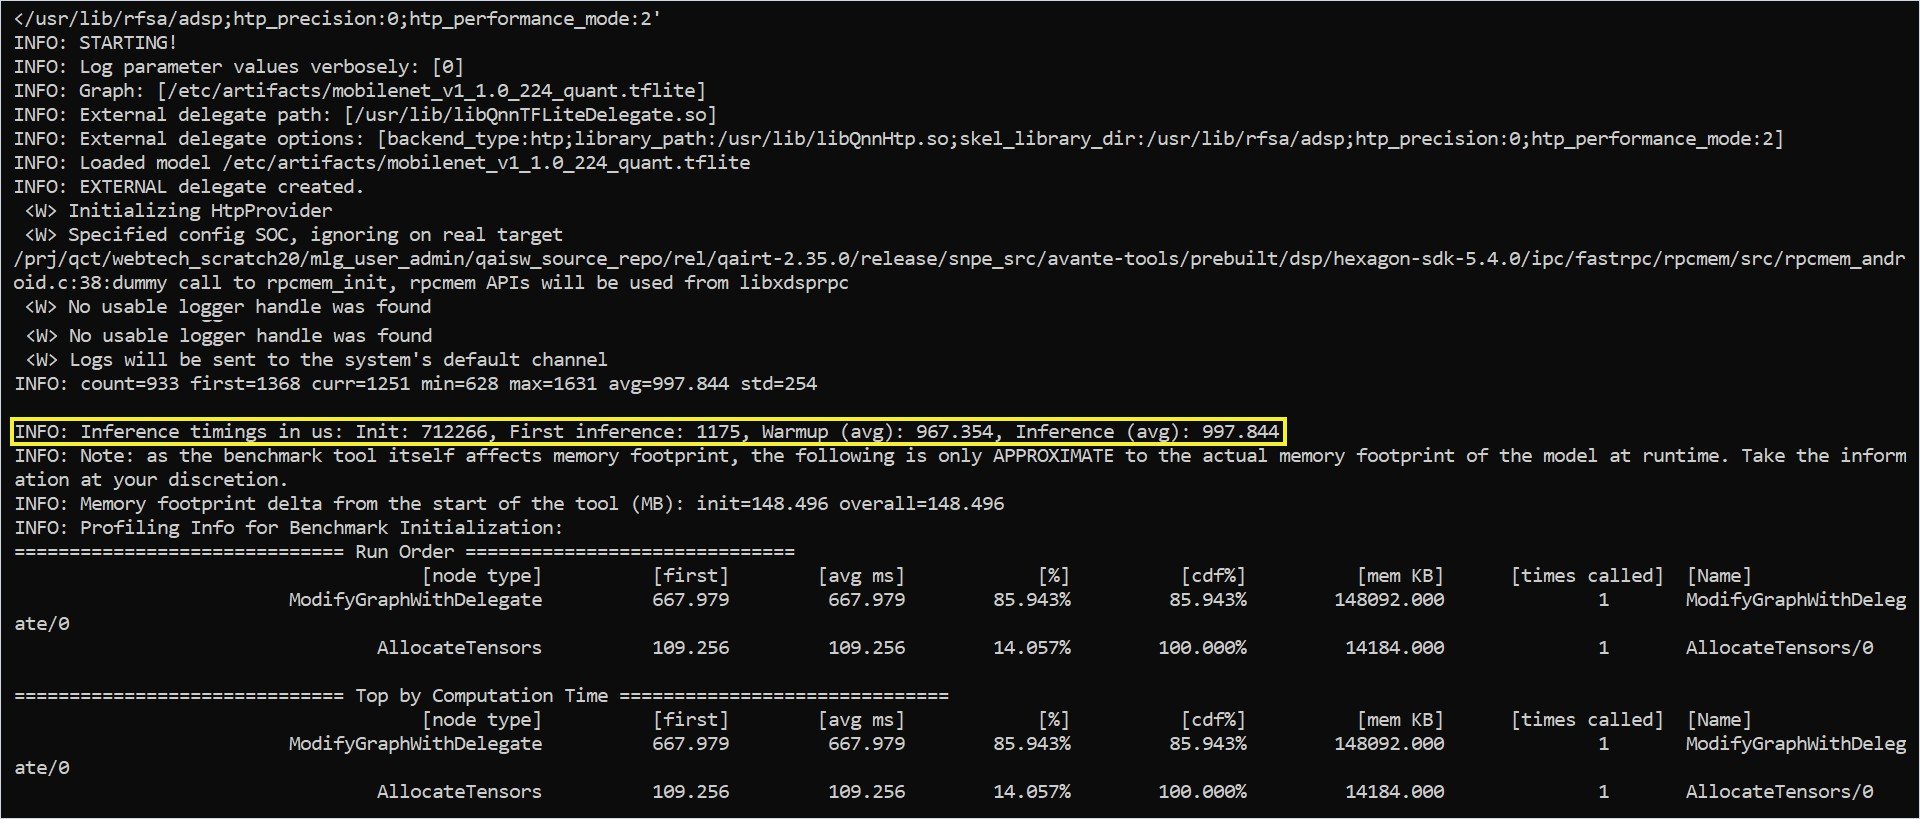
benchmark_model 工具统计信息