

label_image 示例应用程序、LiteRT C++ API 或 Qualcomm IM SDK 的 gst-ai-classification 管道,在 Qualcomm 开发套件上运行 LiteRT 模型。
在部署之前,请确保您已完成前提条件和模型设置。
部署为原生应用程序
label_image 示例应用程序是 TensorFlow 仓库的一部分,已使用 LiteRT 库交叉编译并安装在目标设备上。它加载一个 LiteRT 分类模型,并使用 delegate 对图片执行推理。
使用 XNNPACK delegate 在 CPU 上运行:
部署为 C++ 应用程序
下图显示了创建 C++ 应用程序以运行 LiteRT 模型的步骤:
创建 C++ 应用程序并运行 LiteRT 模型的工作流
加载 LiteRT 模型
LiteRT 模型是一个包含模型算子、权重和偏置的 FlatBuffers 文件。使用以下 API 加载模型以进行推理:创建 LiteRT 解释器
解释器配置模型在所选 delegate 上的执行,并为前向传播分配内存:使用 delegate 准备模型
以下示例创建 XNNPACK delegate,用于在 Arm® CPU 上运行 LiteRT 模型:准备输入/输出缓冲区
在运行推理之前,请对输入数据(例如摄像头帧)进行预处理,以匹配模型期望的格式。常见的预处理步骤包括:- 将输入图像缩放到模型期望的分辨率
- 归一化
- 均值减除
运行推理
使用Invoke() API 运行推理。完成后,从解释器中解析输出张量:
使用 Qualcomm IM SDK 部署
gst-ai-classification 示例应用程序使用 Qualcomm IM SDK 插件,在 Qualcomm 开发套件上以硬件加速方式运行 LiteRT 分类模型。
管道接收来自摄像头的视频流,执行预处理,在 AI 硬件上运行推理,并显示结果:
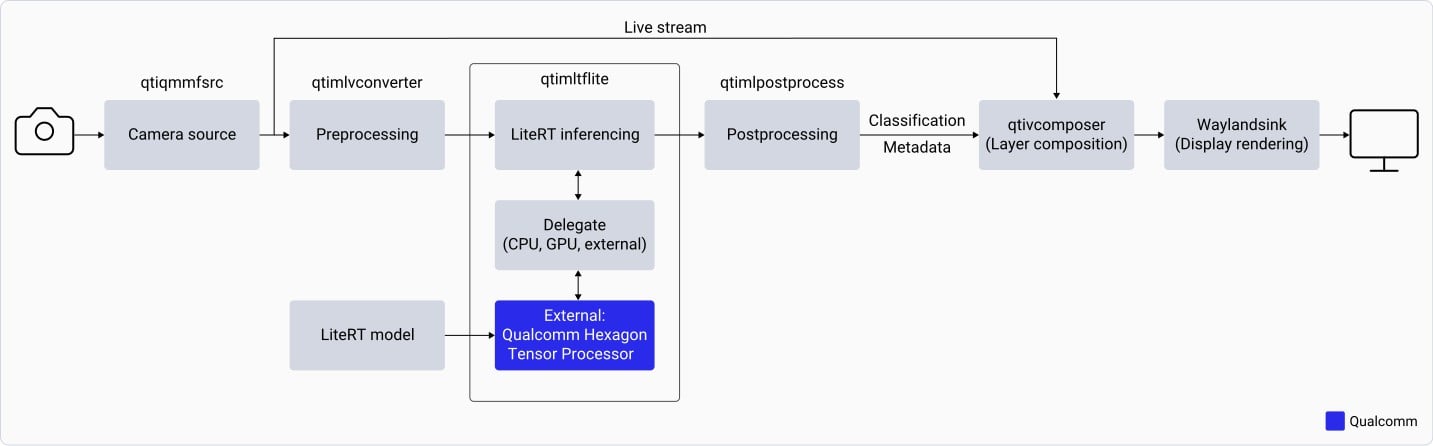
使用 Qualcomm IM SDK 的 LiteRT 模型管道
gst-ai-classification 应用程序:
- 以指定的分辨率和帧率(例如 1080p、30 fps)打开 IMX577 摄像头。
- 对每个摄像头帧进行预处理——缩小到 224×224 并根据模型要求进行归一化。
- 加载 LiteRT 分类模型,并使用
qtimltflite插件运行推理。 - 从输出张量中提取预测概率最高的标签。
- 将推理结果叠加在原始摄像头帧上,并显示在连接的显示器上。
下载模型和标签文件
- 前往 Qualcomm AI Hub 并下载 Inception-v3 量化模型。
-
下载标签文件:
-
在目标设备上,创建所需目录:
-
将模型和标签文件复制到设备:
运行示例应用程序
-
使用 SSH 登录目标设备:
-
编辑
/etc/configs/config_classification.json配置文件: -
将一个视频文件复制到设备上的
/etc/media/video.mp4。 -
运行分类示例应用程序:
要停止应用程序,请按
Ctrl+C。