使用 Neural Processing Engine 部署模型 模型 DLC(量化或非量化)可以通过启用了 SNPE 的应用(使用 SNPE C/C++ API 编写的应用)进行部署。SNPE 提供了用于加载 DLC、选择运行模型的运行时以及执行推理等的 API。 SNPE 提供了预构建的 snpe-net-run 工具(使用 C API 编写的应用),它可以加载任意模型 DLC 并对提供的输入运行该模型。
**模型文件:**由 SNPE 转换器工具或 snpe-dlc-graph-prepare 工具(如果在 HTP 上运行)生成的 DLC 模型文件。
**输入列表:**文本文件,类似于量化时使用的 input_list.txt 文件,不同之处在于此列表中的输入 raw 文件用于推理。为简单起见,本示例中推理使用与量化相同的输入列表。
**运行时:**用户必须选择在目标设备上运行模型的特定运行时。可用的运行时选项包括 CPU、GPU 和 DSP(HTP)。
有关更多详情,请参阅 snpe-net-run --help。
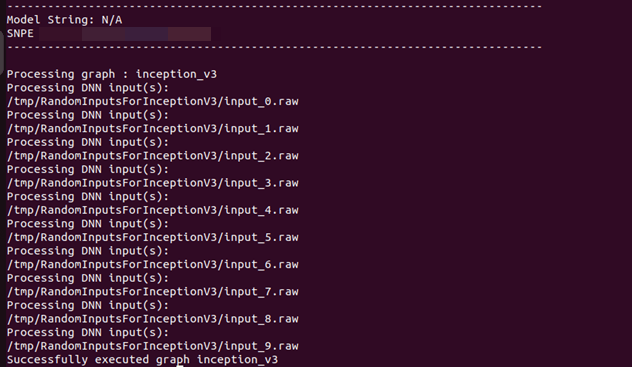
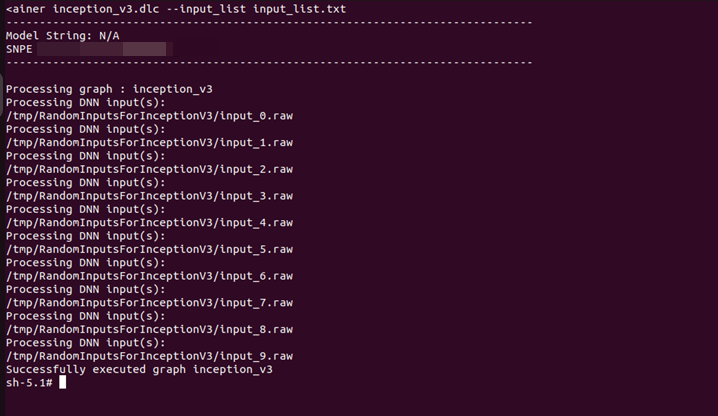
运行 SNPE .dlc:x86 主机 转换后的 SNPE .dlc 可以使用 snpe-net-run 工具运行,该工具以 .dlc 和输入列表作为参数。在 x86 上运行 SNPE DLC 纯粹用于调试目的。 例如,以下命令加载 inception_v3.dlc 模型并在 x86 CPU 上运行该模型。它将输出文件生成到 /output_x86/。
SNPE 的默认运行时是 CPU。使用 snpe-net-run 执行模型时,无需指定 CPU 运行时。
准备 SNPE 模型以在目标设备上运行 要在目标设备上运行模型,snpe-net-run 需要模型 .dlc、SNPE 运行时库和输入列表来运行推理以生成输出。
在目标设备上运行之前,请确保已将 SNPE SDK 二进制文件和库推送到目标设备。
使用来自 ${QAIRT_ROOT}/lib/aarch64-oe-linux-gcc11.2 和 ${QAIRT_ROOT}/bin/aarch64-oe-linux-gcc11.2 的工件 为 Qualcomm 评估套件使用正确的 DSP Hexagon 架构库: 适用于 Qualcomm 评估套件的 Hexagon 架构库
对于其他硬件的 Hexagon 架构,请查看此页面 。 需要在主机上执行以下 scp 命令,将 SNPE SDK 库和二进制文件复制到设备。
对于 IQ-8275,将 <dsp-arch> 替换为 75;对于 IQ-9075,替换为 73;对于 Qualcomm Dragonwing™ RB3 Gen 2,替换为 68。
上述步骤已为模型执行准备好设备。以下各节详细说明如何在可用的运行时上运行模型。 运行 SNPE .dlc:基于 Arm 的 CPU 在执行模型之前设置环境变量,以确保 SNPE 二进制文件和库可用于运行模型。
SNPE 的默认运行时是 CPU。使用 snpe-net-run 执行模型时,无需指定 CPU 运行时。
运行 SNPE DLC:GPU 要在 GPU 运行时上运行模型,请使用 inception_v3.dlc 并将输出保存在 output_gpu 中。 在目标设备的终端中,运行以下命令以启用 GPU 委托和后端:
要在 GPU 上运行,请使用 --use_gpu 命令行参数指定运行时。
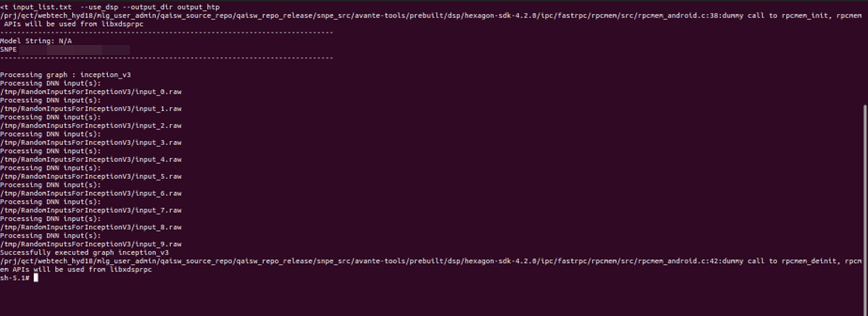
运行 SNPE DLC:HTP 要在 HTP 后端上运行模型,请使用 inception_v3_quantized_with_htp_cache.dlc 并将输出保存在 output_htp 中。
要在 HTP 上运行,请使用 --use_dsp 命令行参数指定运行时。
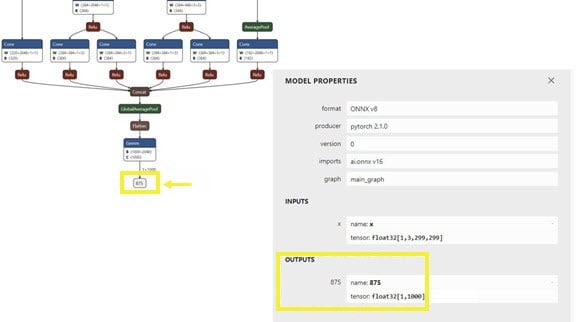
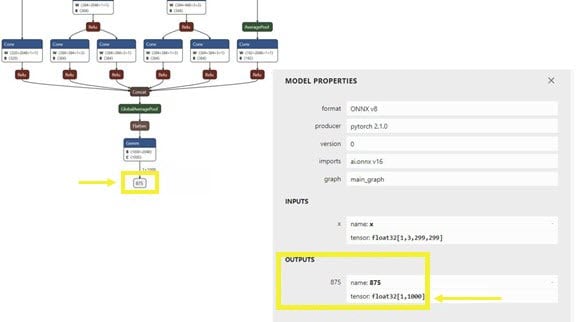
验证输出 对于馈送给 snpe-net-run 的每个输入 raw 文件(通过 input_list 文件),都会生成一个输出文件夹,其中包含保存为 raw 文件的输出张量,其大小与模型的输出层相匹配,如下图所示。 在 inception_v3 示例中,输出 raw 文件是一个二进制文件,包含 1000 个分类类别的概率。 我们使用 Python 脚本将该文件读取为 NumPy 数组,以执行后处理和输出验证。以下示例检查 HTP 预测是否与 CPU 预测相同。
将输出文件复制到主机
将输出文件从目标设备复制到主机,以便验证输出。
在以下(compare.py)Python 脚本中使用上述命令中的 <path>。
比较 CPU 和 HTP 输出张量
将设备端推理的输出复制到主机后,准备一个脚本,加载保存在 output_htp 和 output_cpu 中的输出张量进行比较。 在本示例中,output_htp 和 output_cpu 都被复制到 ~/models 目录。 以下是比较其中一个示例输入输出的示例脚本。可以使用 numpy.fromfile(…) API 将 snpe-net-run 的输出加载到 NumPy ndarrays 中。
默认情况下,snpe-net-run 以 float32 格式将输出张量保存到 NumPy 文件中。
输出: 使用 SNPE API 进行部署 SNPE SDK 提供 C/C++ API,用于创建/开发在所选硬件(CPU、GPU 或 HTP)上以加速方式运行模型的应用。请参阅演示 SNPE C/C++ API 的示例应用 。 为了在构建完整用例管线(从摄像头串流、预处理图像、执行推理等)时改善开发者体验,SNPE 已作为插件(qtimlsnpe)集成到 Qualcomm IM SDK 中。 该插件基于 SNPE C API 开发,提供 SNPE 功能(加载和运行模型)。借助 qtimlsnpe 插件,您可以在 Qualcomm IM SDK 管线中使用转换后的模型 DLC 来实现用例。 有关如何使用 Qualcomm IM SDK 部署 SNPE DLC 的说明,请参阅 Qualcomm IM SDK 概述 。 使用 AI Engine Direct 部署模型 模型 .so(量化或非量化)可以通过启用了 QNN 的应用(使用 QNN C/C++ API 编写的应用)进行部署。QNN 提供了动态加载模型 .so 并使用所选后端在硬件上运行模型的 API。 QNN 提供了一个预构建工具(qnn-net-run ),它可以动态加载此模型 .so,并使用提供的输入在所选后端上执行推理。 对于 CPU、GPU 或 HTP 执行,qnn-net-run 需要以下参数:
**模型文件:**由 qnn-model-lib-generator 生成的 .so 文件
**后端文件:**目标后端的 .so 文件
CPU 后端使用 libQnnCpu.so。
GPU 后端使用 libQnnGpu.so。
HTP 后端使用 libQnnHtp.so。
**输入列表:**文本文件,类似于量化时使用的 input_list.txt 文件,不同之处在于此列表中的输入 raw 文件用于推理。为简单起见,本示例中推理使用与量化相同的输入列表。
运行 QNN .so:x86 主机 转换后的 QNN .so 可以使用 qnn-net-run 工具运行,该工具以模型 .so、后端库 .so 和输入列表作为参数。 例如,以下命令加载 libinception_v3.so 模型并在 x86 CPU 上运行该模型。它将输出文件生成到 ~/models/output_x86/。 准备 QNN 模型以在目标设备上运行 要在目标设备上运行模型,qnn-net-run 需要模型 .so、QNN 二进制文件和运行时库以及输入列表来运行推理以生成输出。
在目标设备上运行之前,请确保已将 QNN SDK 二进制文件和运行时库推送到目标设备。
使用来自 ${QAIRT_ROOT}/bin/aarch64-oe-linux-gcc11.2 和 ${QAIRT_ROOT}/lib/aarch64-oe-linux-gcc11.2 的工件 为 Qualcomm 评估套件使用正确的 DSP Hexagon 架构库: 适用于 Qualcomm 评估套件的 Hexagon 架构库
对于其他硬件的 Hexagon 架构,请查看此页面 。 在主机上运行以下 scp 命令,将 QNN SDK 库和二进制文件复制到设备。
对于 IQ-8275,将 <dsp-arch> 替换为 75;对于 IQ-9075,替换为 73;对于 Qualcomm Dragonwing™ RB3 Gen 2,替换为 68。
上述步骤已为模型执行准备好设备。以下各节详细说明如何在可用的运行时上运行模型。 运行 QNN .so:基于 Arm 的 CPU 在基于 Arm 的 CPU 上运行模型时,qnn-net-run 需要模型 .so、后端 .so 库和输入列表来运行推理以生成输出。 对于 RB3Gen2 目标设备,.so 必须使用 aarch64-oe-linux-gcc11.2 工具链交叉编译。 例如,以下命令将输出文件写入 /opt/output_cpu/。 在 GPU 上运行 QNN 模型 在目标设备的终端中,运行以下命令以启用 GPU 委托和后端: 在 Adreno GPU 上执行模型时,qnn-net-run 需要模型 .so、后端 .so 库(libQnnGpu.so)和输入列表来运行推理以生成输出。 例如,以下命令将输出文件写入 /opt/output_gpu/。 在 HTP 后端上运行 QNN 模型 要在 HTP 后端上运行模型,请使用 libquantized_inception_v3.so 库和 libQnnHtp.so 后端库,并将输出保存在 output_htp 目录中。 验证输出 对于馈送给 qnn-net-run 的每个 raw 输入文件(通过 input_list 文件),都会生成一个输出文件夹,其中包含 raw 输出文件,其大小与模型的输出层相匹配,如下图所示。 在此 inception_v3 示例中,raw 输出文件是一个二进制文件,包含 1000 个分类类别的概率。 您可以使用 Python 脚本将该文件读取为 NumPy 数组,以执行后处理和输出验证。以下示例脚本检查 HTP 预测是否与 CPU 预测相同。
在以下 Python 脚本中使用上述命令中的 <path>。
将 qnn-net-run 工具的输出从设备复制到主机后,创建一个简单的 Python 脚本,加载 CPU 和 HTP 执行的输出并使用 NumPy 进行比较。 输出: 使用 QNN API 进行部署 Qualcomm AI Engine Direct SDK 提供 C/C++ API,用于创建/开发能够加载已编译 .so 模型并在所选后端(CPU、GPU 或 HTP)上以加速方式运行的应用。请参阅演示 QNN C/C++ API 的示例应用 。 使用 Qualcomm IM SDK 进行部署 为了在构建完整用例管线(从摄像头串流、预处理图像、执行推理等)时改善开发者体验,QNN 已作为 qtimlqnn 插件集成到 Qualcomm IM SDK 中。 该插件基于 QNN C API 开发,提供动态加载和运行模型的能力。借助 qtimlqnn 插件,开发者可以在 Qualcomm IM SDK 管线中使用其转换和编译后的模型库来实现用例。 有关如何使用 Qualcomm IM SDK 部署 QNN 模型的说明,请参阅 Qualcomm IM SDK 概述 。 使用 QAIRT 部署模型 模型 .bin 可以通过启用了 QAIRT 的应用(使用 QAIRT C/C++ API 编写的应用)进行部署。QAIRT 提供了动态加载模型 .bin 并使用所选后端在硬件上运行模型的 API。 QAIRT 提供了一个预构建工具(qairt-net-run),它可以动态加载此模型 .bin,并使用提供的输入在所选后端上执行推理。 对于 CPU、GPU 或 HTP 执行,qairt-net-run 需要以下参数:
**模型文件:**用于在 HTP 上推理的由 qairt-dlc-prepare 生成的 .bin 文件,以及用于在 CPU 和 GPU 上推理的由 qairt-converter 生成的 .dlc 文件。
**后端文件:**目标后端的 .so 文件。
CPU 后端使用 libQairtCpu.so。
GPU 后端使用 libQairtGpu.so。
HTP 后端使用 libQairtHtp.so。
**输入列表:**文本文件,类似于量化时使用的 input_list.txt 文件,不同之处在于此列表中的输入 raw 文件用于推理。为简单起见,本示例中推理使用与量化相同的输入列表。
在 x86 主机上运行 DLC 转换后的 QAIRT DLC 可以使用 qairt-net-run 工具运行,该工具以模型 .dlc、后端库 .so 和输入列表作为参数。例如,以下命令加载 inceptionv3.serialized.bin 模型并在 x86 CPU 上运行该模型。它将输出文件生成到 ~/models/output_x86/。 运行以下命令在 x86 机器上对模型进行推理: 准备在目标设备上运行模型 要在目标设备上运行模型,qairt-net-run 需要模型 .bin、.dlc、QAIRT 二进制文件和运行时库以及输入列表来运行推理以生成输出。
在目标设备上运行之前,请确保已将 QAIRT SDK 二进制文件和运行时库推送到目标设备。
使用来自 ${QAIRT_ROOT}/bin/aarch64-oe-linux-gcc11.2 和 ${QAIRT_ROOT}/lib/aarch64-oe-linux-gcc11.2 的工件。 为 Qualcomm 评估套件使用正确的 DSP Hexagon 架构库: 在主机上运行以下 scp 命令,将 QAIRT SDK 库和二进制文件复制到设备。
对于 IQ-8275,将 <dsp-arch> 替换为 75;对于 IQ-9075,替换为 73;对于 Qualcomm Dragonwing™ RB3 Gen 2,替换为 68。
运行以下命令,将所有模型、input.txt 和 raw 文件推送到目标设备 在基于 Arm 的 CPU 上运行 QAIRT .dlc 在基于 Arm 的 CPU 上运行模型时,qairt-net-run 需要模型 .dlc、后端 .so 库和输入列表来运行推理以生成输出。
例如,以下命令将输出文件写入 /opt/output_cpu/。 在 GPU 上运行 QAIRT 模型 运行以下命令以启用 GPU 委托和后端: 在 Adreno GPU 上执行模型时,qairt-net-run 需要模型 .dlc、后端 .so 库(libQairtGpu.so)和输入列表来运行推理以生成输出。
例如,以下命令将输出文件写入 /opt/output_gpu/。 在 HTP 上运行 QAIRT 模型 要在 HTP 后端上运行模型,请使用模型 .bin 文件和 libQairtHtp.so 后端库,并将输出保存在 output_htp 目录中。 验证输出 对于馈送给 qairt-net-run 的每个 raw 输入文件(通过 input_list 文件),都会生成一个输出文件夹,其中包含 raw 输出文件,其大小与模型的输出层相匹配,如下图所示。 在此 inception_v3 示例中,raw 输出文件是一个二进制文件,包含 1000 个分类类别的概率。您可以使用 Python 脚本将该文件读取为 NumPy 数组,以执行后处理和输出验证。以下示例脚本检查 HTP 预测是否与 CPU 预测相同。 将 qairt-net-run 工具的输出从设备复制到主机后,创建一个简单的 Python 脚本,加载 CPU 和 HTP 执行的输出并使用 NumPy 进行比较。 输出: 使用 QAIRT API 进行部署 QAIRT SDK 提供 C/C++ API,用于创建/开发能够加载已编译 .bin 模型并在所选后端(CPU、GPU 或 HTP)上以加速方式运行的应用。请参阅演示 QAIRT C/C++ API 的示例应用